2026-04-17 第一天
苏昊(复旦 GPI)— 具身智能与世界模型
具身智能的难点在于物理智能。认为世界模型可分为以下几类:
- 几何重建,如 3DGS、VGGT、WorldLab 等,认为无法还原物理;
- 视频生成,如 Sora 等,认为只是在建模(视频 | 文字)先验概率;
- VLA,如 OpenVLA,仍依赖 VLM 的视觉理解。
认为物理理解需要建模(结果 | 执行行为)的先验概率,更深层需要反事实推理。认为需要虚拟物理模型,如 MolmoBot。
郭春超(混元 3D)— 3D 生成迈向世界模型
3D 生成模型从 2024 年的百万级参数规模扩展到如今的十亿级参数规模,所需算力达百卡乃至千卡,迭代模型需千万级研发投入。
未来方向:
- 高精度、原生可交互、对齐游戏管线的 3D 生成;
- 世界模型方向,目前关注游戏/VR、真实场景及可交互 3D 场景生成。
张兆翔(自动化所)— 世界模型
工作:NeoVerse(arXiv:2601.00393,CVPR 2026)。从重建效率和海量单目视频数据在线处理角度,尝试解决 4D 前馈模型的 Scaling 问题,在自动驾驶、机器人新视角合成等领域有应用。
未来:构建通用世界模型 Benchmark。
周晓巍(浙大 CAD)— 4D 空间场景
与影视飓风合作。正在研究方向:
- 单目视频重建——4DAnyone;
- 实时重建——PointSplat;
- 4D 场景编辑,包括分割(4DGS Segmentation:2D 分割后投票 + Tracking)和重光照(OLED)。
未来:需要更好的 4D 表征和更多的 4D 数据。
徐英豪(港科大)— Streaming 3D 重建 / SLAM
- LingBot-Map:在长视频、室内复杂场景中保持良好一致性;
- LingBot-World:数据处理是关键;
- LingBot-VA:采用交织式 VA 模型和自回归 Memory,机器人操作效果较好。
吴尚哲(剑桥)— 物理运动模拟
工作:
- Feed-Forward 3D Object Articulation:从静态物体直接预测旋转轴运动;
- Neural 3D Kinematics:刚体物体运动建模。
陈安沛(西湖大学 Inception3D)— 前馈场景重建
认为模拟现实有三条路线:
- 视频生成(Sora),效率低、一致性差;
- 3D 表征(World Labs),数据稀少;
- 隐特征,缺少先验、长序列一致性差。
认为时空动态应以物体为中心。工作:先生成 3D,再通过视频生成重建动态。
汤思宇(ETH Zurich)— 医学手术场景 4D 孪生
医学手术数据采集:多模态数据包括护士视角、医生视角、固定视角、CT 图等,已有沉浸式手术观看平台。
前馈 3D 重建模型问题:VGGT(arXiv:2503.11651)多视角对齐差、泛化能力弱;DA3 多视角对齐差。希望结合 SfM 的几何约束和前馈 3D 回归的优势。
工作:GGPT,模型可迁移、泛化能力强。
未来:提升 4D 几何与运动精度。
戴玉超(西工大)— 2D 约束的 3D 重建
工作:有限视角的 3D 重建,利用生成模型获取目标视角信息。
另:《中国图象图形学报》面向空间智能专题征稿中。
Gordon Wetzstein(斯坦福 Physical and Spatial Intelligence Lab)— 长上下文视频世界模型
认为世界模型的任务是由当前状态和动作推测下一状态,数据驱动型模拟只能通过观察获取状态。
主要工作方向:
- Long-Context:长视频生成受有限上下文窗口制约(视频上下文难以扩展),防遗忘机制非常重要,方法与 Lyra 2.0 相近;
- Multiplayer:以自定义地图的深度/视差作为输入,模型同时预测玩家的物理行为,Demo 见 play-multigen.com;
- Control:眼部跟踪 Foveated Diffusion,仅对注视区域内的 Token 做高精度细化;
- Autoregressive Drift:反向视频序列预测,结合 DAgger。
World-Agents:传统模拟器数据量大但缺乏多样性,”完美”世界模型数据丰富但无法直接训练 RL 策略,有监督学习标注的机器人动作数据过少。Rhoda AI 的 Direct Video-Action Model 可参考 rhoda.ai/research/direct-video-action。
未来挑战: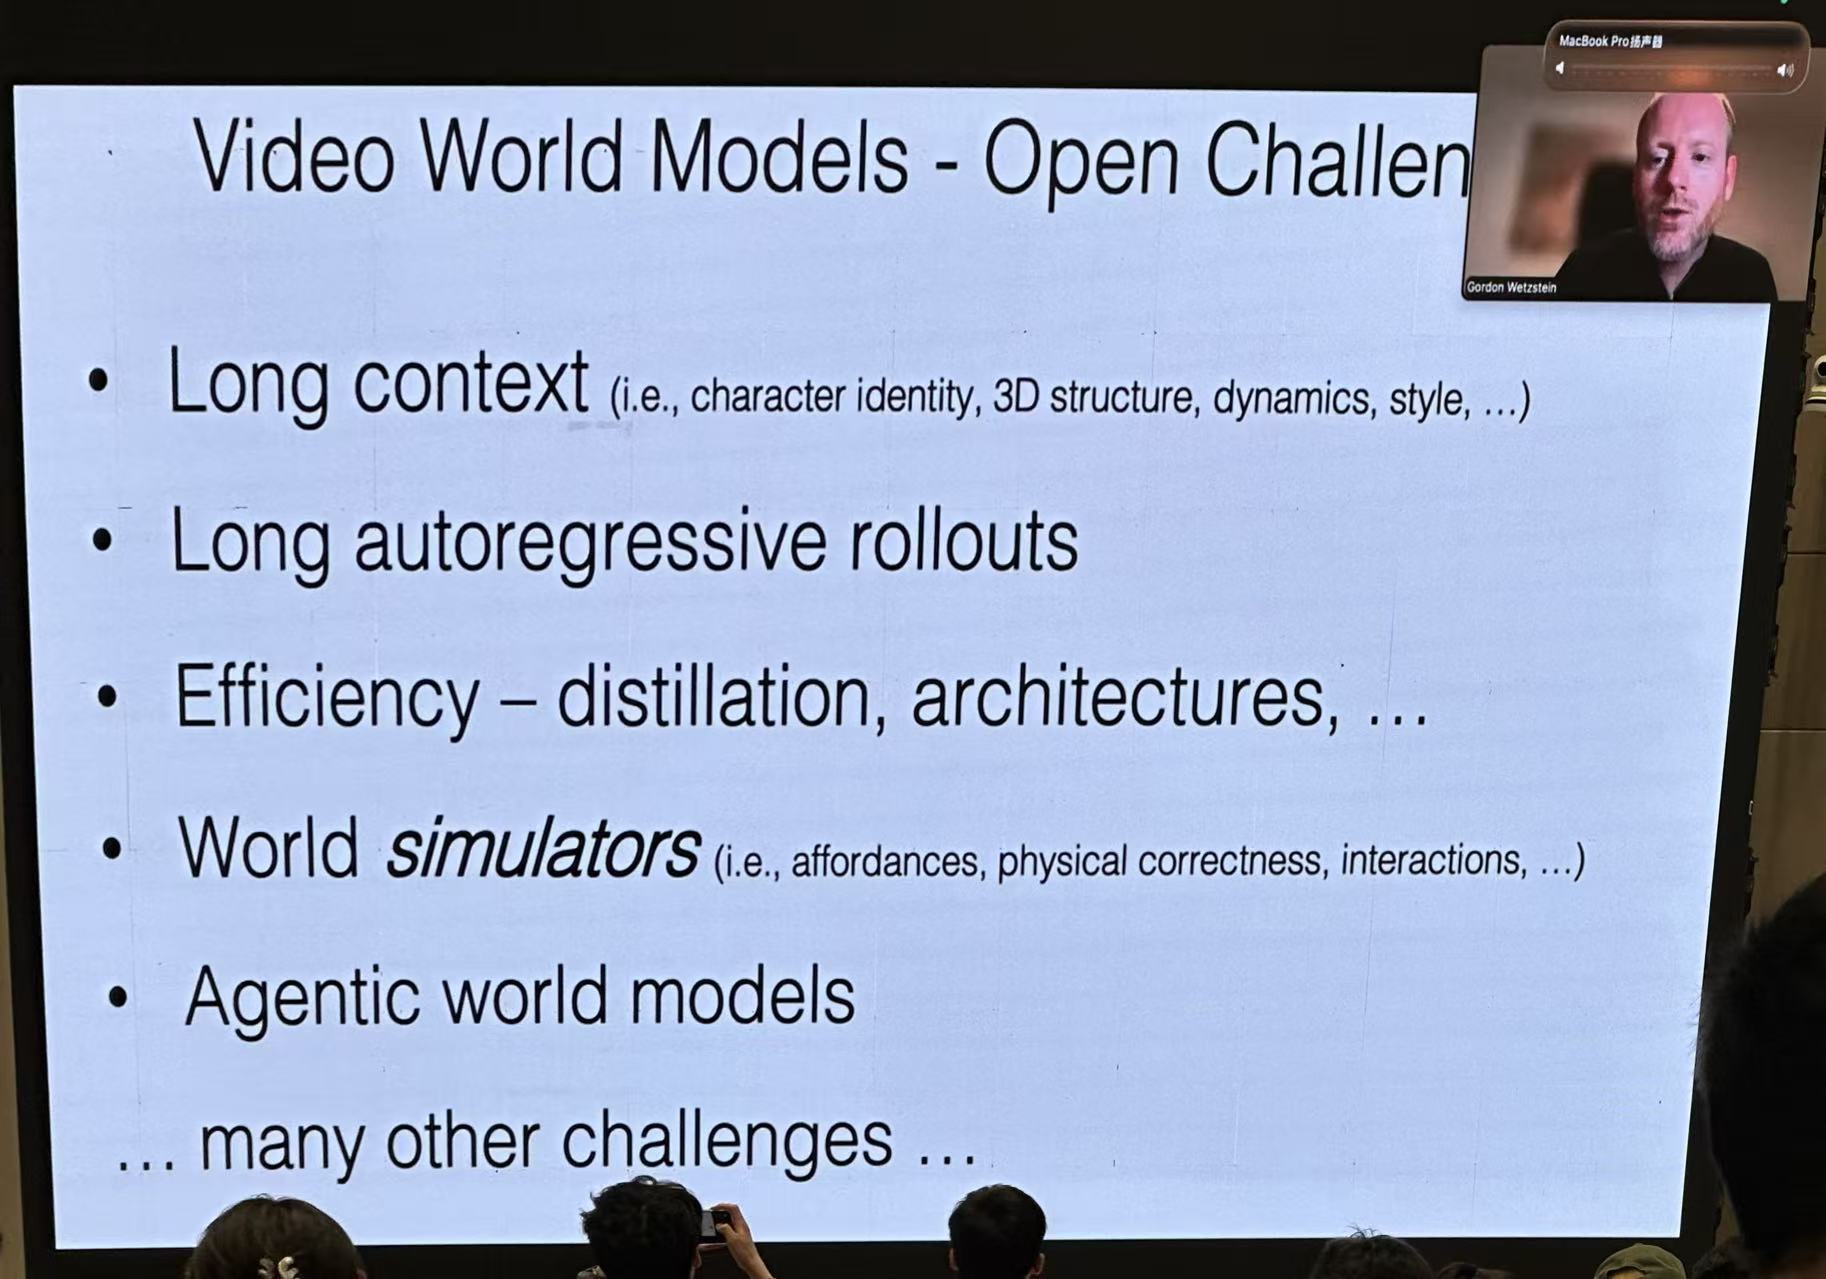
问:世界模型的未来是什么?答:受数据量制约,他认为仍属于可 Scale 的视频模型。
胡渊鸣(Meshy AI)— 3D 生成独角兽企业
分析图形学领域商业图谱与人才溢出现象。分享创业经历:创业磨练人。
高盛华(港大)— 机器人具身智能
工作:CUPID,单图物体与相机位姿联合生成式重建,辅助机器人锚定物体的相对位置。
认为重建式方法提供准确几何,生成式方法能提供 2D-3D 一致性。
廖依伊(浙大)— 视频扩散模型
认为视频扩散中的 3D 先验已经历了从无位姿、Warp-based、绝对相机位姿到相对相机位姿的发展历程。
工作:
- ReRoPE:将相对相机位姿 Token 直接注入扩散模型的低频参数;
- Gen3R(arXiv:2503.18945):通过参数对齐在隐特征空间联合 VGGT 重建和 Wan 生成模型。
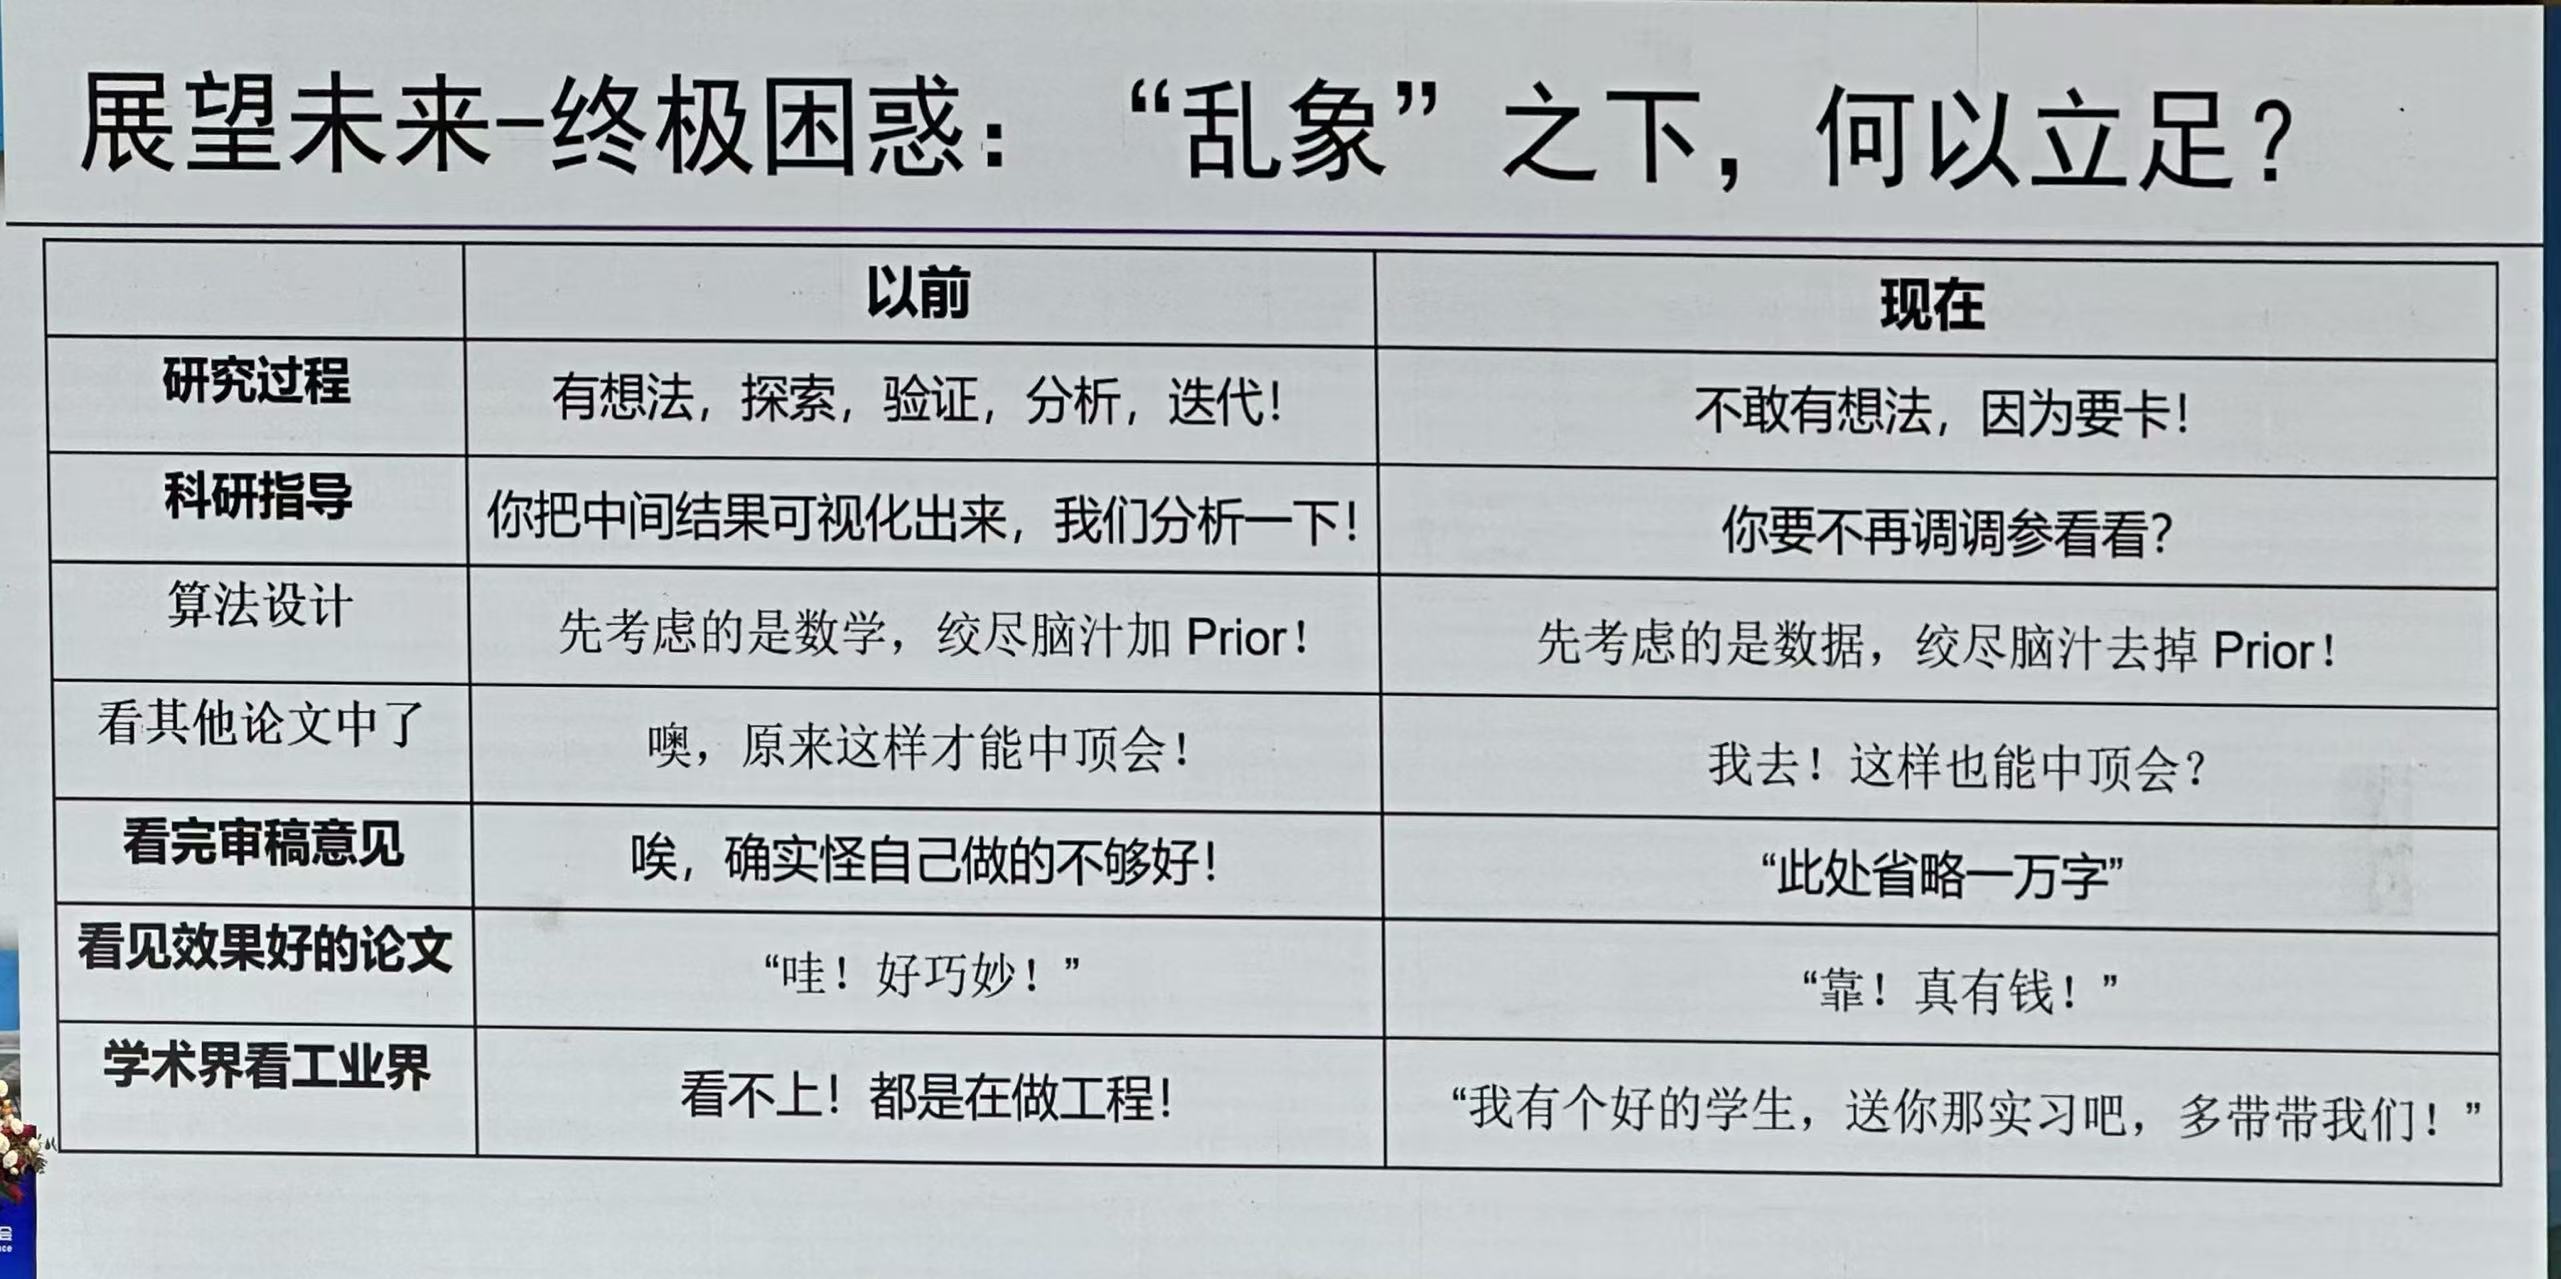
韩晓光(港中文深圳)— 数字人迈向具身
分享转型到具身方向的心得:好处是投资多、显卡多;阻力包括学生论文连贯性差、机器人真机实验麻烦等。
尝试方向:生成可交互场景、3D/4D 物体生成、机械臂模仿人手动作。
杨蛟龙(微软亚洲)— 三维物体生成
工作:TRELLIS 2.0,采用”native”原生 3D 方案(arXiv:2412.01506),无 Scene 概念。采用 O-Voxel 中间表示以获取锐利几何,压缩率更高的 VAE。
近期方向:更精细的灰模生成。
许岚(上科大)— 三维物体生成
过往工作:CLAY、BANG、HYPER3D 物体编辑等。
被拒工作:SEEN,与 2D 图片联合训练,输入图片可更改表面材质。
张彪(西交)— 3D 生成与 3D 表征
认为 3D 生成分为显式稀疏(如 TRELLIS)和隐式稀疏(如混元)两条路线。
工作:
- VecSet:隐式稀疏表征;
- Geometry Distributions:建模 SDF 的分布,训练时间较长;
- Nexus:快速图转 Mesh 方案。
刘缘(港科大)— 3D 生成与 LLM
工作:
- Know3D:结合 Qwen2.5-VL 补充单图生成的背面细节;
- NaLA:将定制资产点云 Token 和位姿 Token 输入 LLM,实现端到端场景摆放;
- PartSegLLM:融合 VLM 的语义分析功能,进行不同尺度的部件分割。
陈昊(浙大百人计划)— 视觉感知与具身智能
认为可以用生成模型做 Autoencoder 和自监督学习。工作:StaMo。
姚遥(南大准聘副教授)— 3D 重建和生成
工作:
- Linbo-Map:靠特殊的 Context Attention 架构获取长视频一致性;
- SpatialVID:YouTube 真实世界视频数据集,但 3D 标注质量不足。与之相比,Genie3 等使用游戏画面作为数据来源。
认为 3D Scaling 的问题还未找到正确方向,手工 3D 数据过少。
陈文拯(北大)— 大规模场景 3D 重建
工作:卫星图大规模城市重建,已落地高德地图。利用极度缺乏视差的数据,重建 2D Mesh,并通过 SDF 预测 Mesh 高度。
赵昊(清华)— 生成模型与具身智能
工作:
- GeoCodeBench:LLM 编程 Benchmark;
- LottieGPT:手搓 Tokenizer 生成 Flash 动画;
- TRELLIS 2.0;
- DKT:半透明物体扩散重建;
2026-04-18 第二天
陈宝权(北大)— 世界模型
首先,世界模型存在路线之争,包括 Genie、LingBot 等视频模型和 Marble 等方案。
其次,认为世界模型至少需满足三个要求:
- 重建真实 3D 世界,工作如前馈模型 SLAM3R(arXiv:2412.09401,CVPR 2025)、MeRM;
- 物理仿真,工作如雨模拟、火模拟;
- 智能体可交互,工作如 Agent 完成场景布置、直接通过代码操控 Blender。
总结:不能止于前馈模型,必须有观测数据的闭环。
虞晶怡(上科大)— 3D 生成
工作:Agentic 3D Generation Pipeline。
认为 Agentic 范式需要 Verifier 和可收敛的 Feedback,目前缺少更好的 MMM 引导空间智能、以及描述空间的更优方式。
工作:CLAY 生成 3D 物体资产,让工业界见识到了可能性;CAST 生成 3D 场景,两项工作均获 SIGGRAPH Best Paper。
认为学界需找到工业界也无法解决的极困难问题作为核心研究方向,必须熟悉工业界前沿。
沈春华(浙大)— 生成模型与世界模型
核心 Insight:充分利用训练好的大模型权重。
工作:
- Depth Any Video(arXiv:2410.10815):利用文生视频模型权重进行微调,认为深度问题已接近解决;
- AETHER(arXiv:2503.18945):多任务视频生成模型;
- Pi3:高精度几何重建;
- WinT3R:流式 3DGS 重建;
- OmniWorld:4D 数据集,包含游戏场景和 GT 3D 数据。
认为多任务模型有前景,联合生成与理解可提升 3D 数据利用效率。
谭平(港科大)— 3D 重建与生成统一
3D 视觉的关注点从”用视觉约束精确几何重建”转变为”用先验概率对齐真实世界来生成几何”,换言之,前者是条件概率,后者是先验或后验概率。
认为 Diffusion Posterior Sampling 比 Score Distillation 更接近减小误差的本质。最近在思考直接由 DDIM 从噪声优化的方案,但面临 OOM 问题。
刘子纬(南洋理工)— 第一人称感知数据
视觉智能数据集从 ImageNet(感知)、Objaverse(几何)演进到 Xperience(动作)。
工作:
- 数据集 Xperience-10M,使用自研 FOV 设备采集;
- PhysX-Anything:引入物理 Token,训练机器人物理感知。
刘烨斌(清华)— 稀疏视点 3D 重建
认为世界模型应以 3D/4D 为路线,但 3D 数据稀疏,高效规模化的 3D 视频采集非常重要且极具挑战。
认为 3D 智能全链条为感知–空间–物理–行为闭环,动态重建、世界模型、具身决策分别处于不同层次。
工作:Mix3R。
施柏鑫(智平方-北大联合实验室)— 具身智能
工作:机器人抓取(含未知场景抓取)、VLA 模型、动态 6D 位姿估计、脉冲相机。
张延柏(灵心巧手)— 具身智能
产品:灵巧手。
王腾飞(混元)— 3D 世界模型
工作:HY-World 2.0 3D 可交互世界模型,综合多个子系统:
- WorldMirror 2.0:3D 重建;
- WorldStereo 2.0:新视角生成;
- WorldPano 2.0:全景生成;
- WorldNav 2.0:相机轨迹生成。
管线:单图/文字全景生成 → 相机轨迹生成 → 新视角生成 → 场景重建。另有 WorldLen(在线 3DGS 渲染平台)和 FlashWorld(快速单视频场景生成)。
孙建飞(奥比中光)— 3D 相机与感知算法
产品:自研双目 3D 相机、结构光相机、激光雷达等多种设备,提供解决方案和算法业务。
陈志文(淘天集团 Meta 团队)— 3D 重建与生成模型研发
产品:淘宝 Vision,3D 商品展示和数字人重建。
未来:MMM 智能导购,可驱动数字人。
黄然(华为)— 鸿蒙方舟图形引擎
未来:大规模场景渲染,以及 YOLO7、DAv2、SHARP 等模型的移动端移植。
章国峰(浙大/影溯)— 3D 重建与生成
引用 Ha 于 2018 年提出的世界模型概念。工作:Inspatio-World
康炳易(KAIST AMI Labs)— 3D 重建
工作:DAv1、DAv2、DA3,专注深度与几何重建。
齐晓娟(港大)— 3D/4D 生成
认为视频生成中出现的不符合物理的现象,源于训练数据中存在特效视频和 AI 生成视频,导致物理数据收集困难。
工作:Stereo World,认为双目输入比单目在原生 3D 能力上更强。
王兴刚(华中科大)— 视觉基座大模型
工作:LightningDiT、DiffusionDrive。
视觉 Tokenizer 预训练,有参数量的 Scaling 性能表现。深度扩展:混合深度注意力(MoDA)引入层间通信,快速版 FDA。
袁粒(北大)— 多模态大模型
认为通用理解需要原生多模态,包括:
- 输入输出原生:不同模态使用同一 Backbone,编解码器可以不同,各模态在 Backbone 中被同等对待;
- 扩散-自回归冲突;
- 梯度冲突。
认为 Agent 链条过慢、信息长链条损失严重。
工作:Helios 自回归扩散视频模型;LLaVA(arXiv:2304.08485,NeurIPS 2023 Oral);新 2D 生成模型(可生成带排版的深度研究图)。
黄高(清华)— 长序列模型架构
工作:
- AgentAttention:引入 AgentToken 层,比 Linear Attention 更智能地处理信息流;
- Mamba-Inspired Linear Attention:从 Mamba 中提取最有效的组件迁移至 Linear Attention;
- ViT3:视觉 TTT(Test-Time Training)。
tele360(展台)— 4–6 稀疏视角实时数字人重建
使用 H.265 压缩高斯点云,实现实时稀疏视角数字人重建。
沉浸式 4D 空间视频(4DV,浙大)— 4D 视频压缩与表征
使用 5 秒 GOP,基于重要性感知机制使高斯点只存在于特定时间段内,有效降低存储量。
2026-04-19 第三天
刘利斌(北大)— 具身智能体
认为智能体应模仿社会场景中人的行为,可采用行为–认知双系统架构。真实场景要求实时性能,并主动进行感知、手工记忆和交流。
未来:端到端视频生成是否有帮助、社会经验是否可积累,以及社会容忍度 Benchmark 的构建。
马月昕(上科大)— 具身智能
以显卡数量划分工作阶段:
1 块显卡(数据采集):
- LiveHPS:用单雷达收集场景级人类动作;
- RoboMirror:人控机器人模拟;
- ManipSynth:生成动作数据。
2 块显卡(Policy 模型):
- ReMOGen:动作生成;
- SymBridge:部署到机器人;
- CoHOH:合作行为。
4 块显卡(训练 VLA):
- ResVLA:利用低频信息。
黄思远(BIGAI)— 人形机器人
认为 99% 的资源用于研究人脑中只有 20% 的神经元,另 80%(如小脑)则极少受关注。从 FigureAI 的 Demo 得到启发,认为机器人需要极好的全身控制器。发现电机功率–动作质量曲线,通用策略越多 Skill、动作质量和效率越差。
工作:OmniXtreme。
Xue Bin Peng(Simon Fraser University)— 机器人动作
工作:
- DeepMimic(arXiv:1804.02717,SIGGRAPH 2018):模仿视频运动,设计动作状态和跟踪奖励函数,用对抗可微判别器学习奖励函数;
- LaFAN1;
- MimicKit。
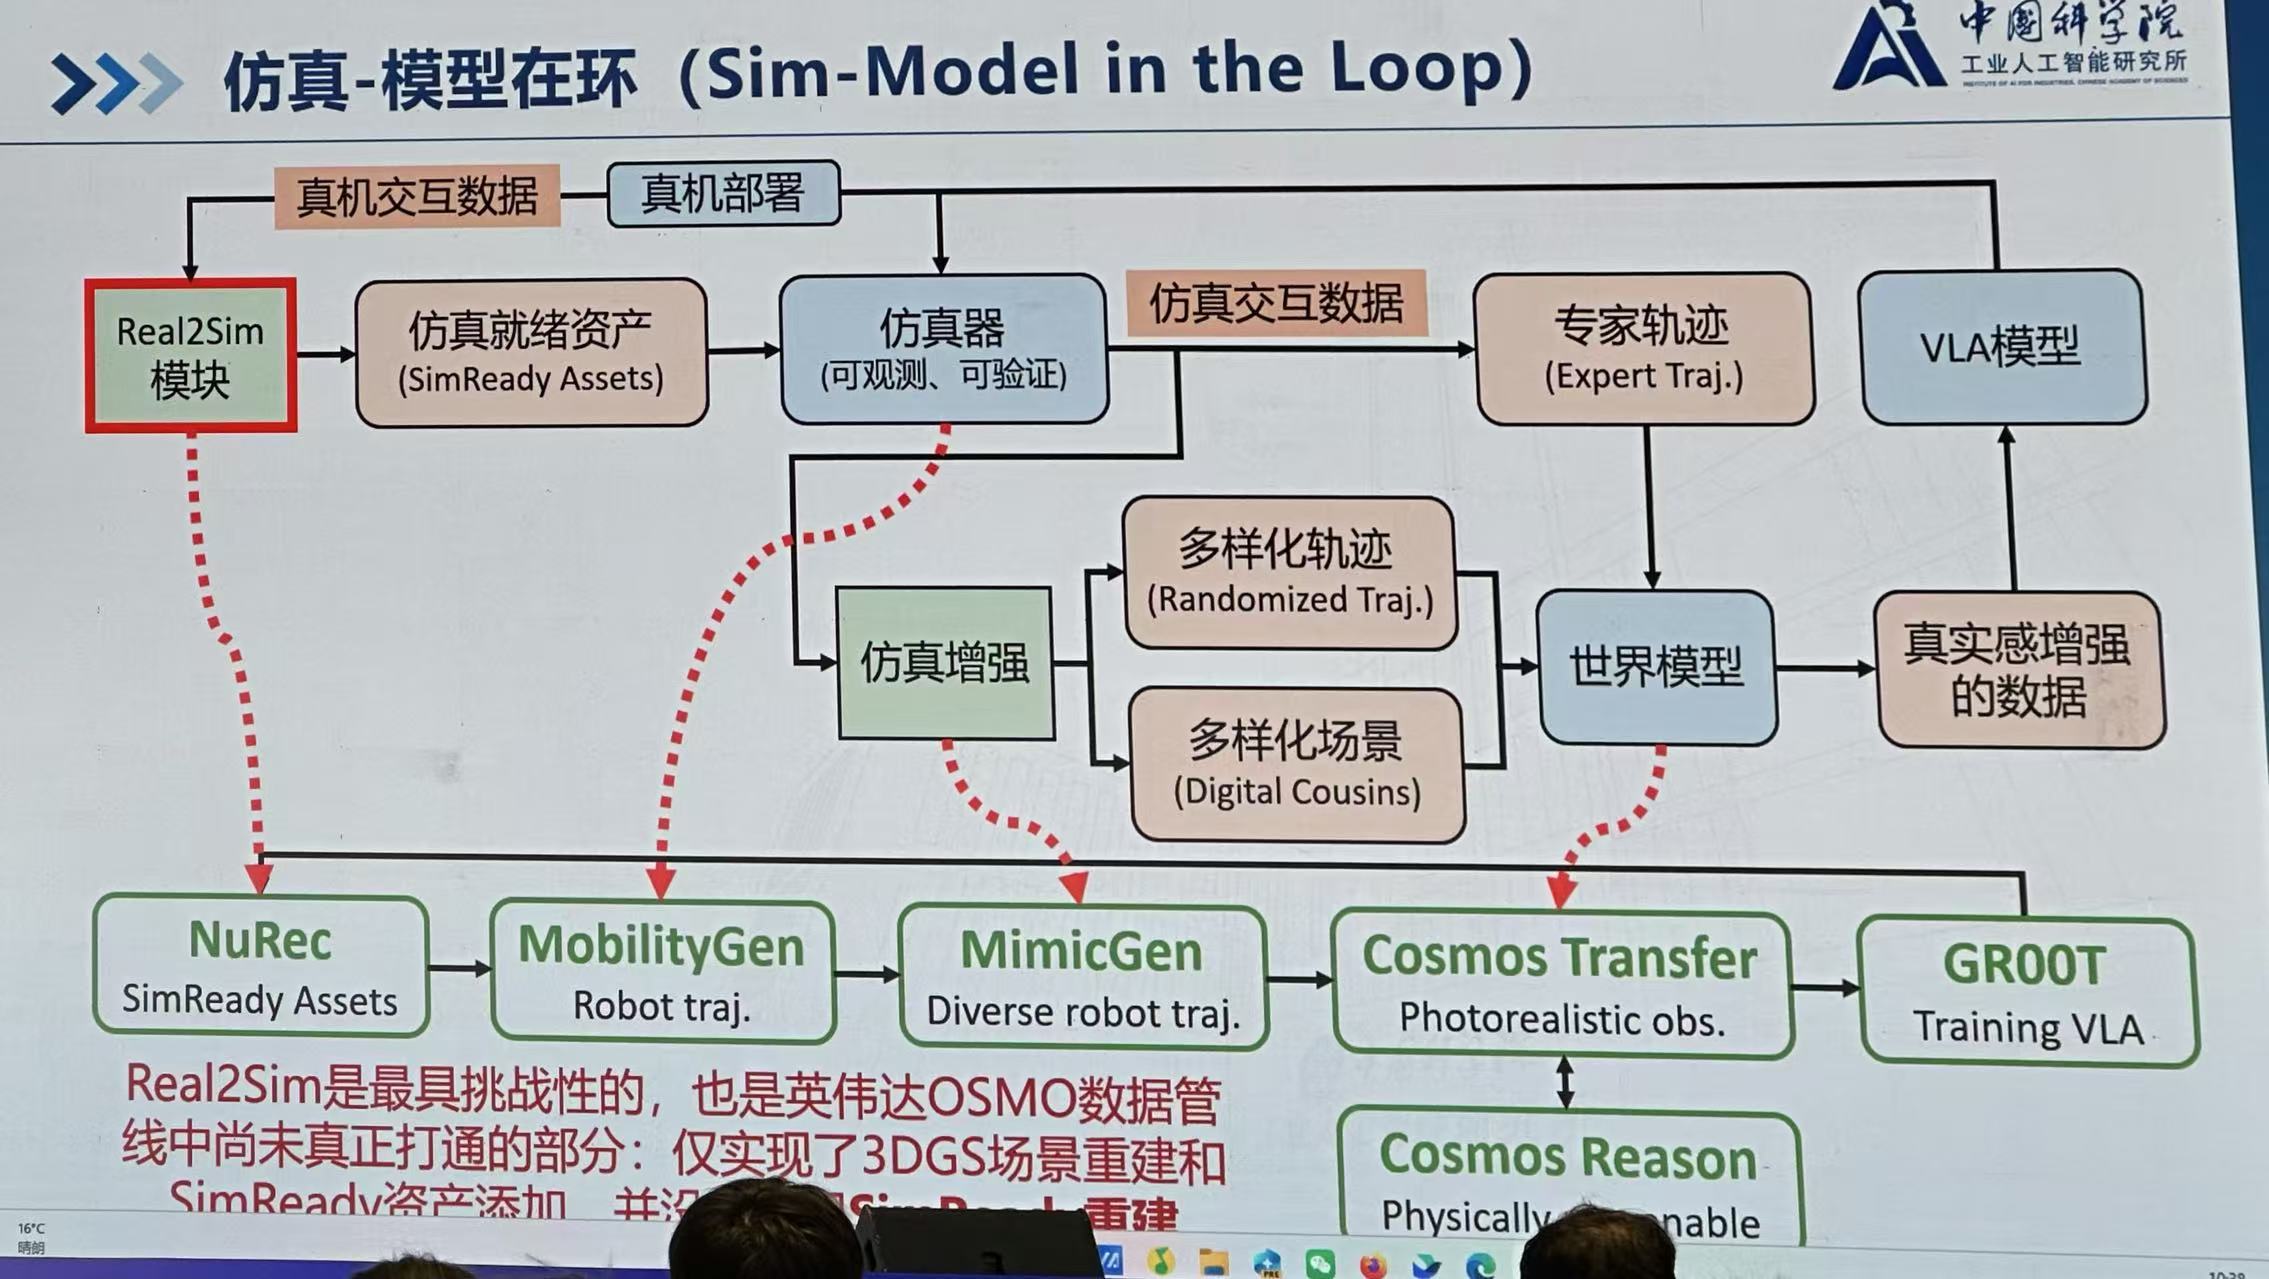
徐凯(中科院工业 AI 所)— 具身智能与真机仿真
认为仿真–模型–真机必须形成真机→仿真的通路才能闭环,这套链路有益于数据利用。世界模型是链路上的仿真模型,仿真器与世界模型可以互相增强。难点在于 Real2Sim,如重建动力学等。
工作:通用世界模型及其 TTT(Test-Time Training)适配。
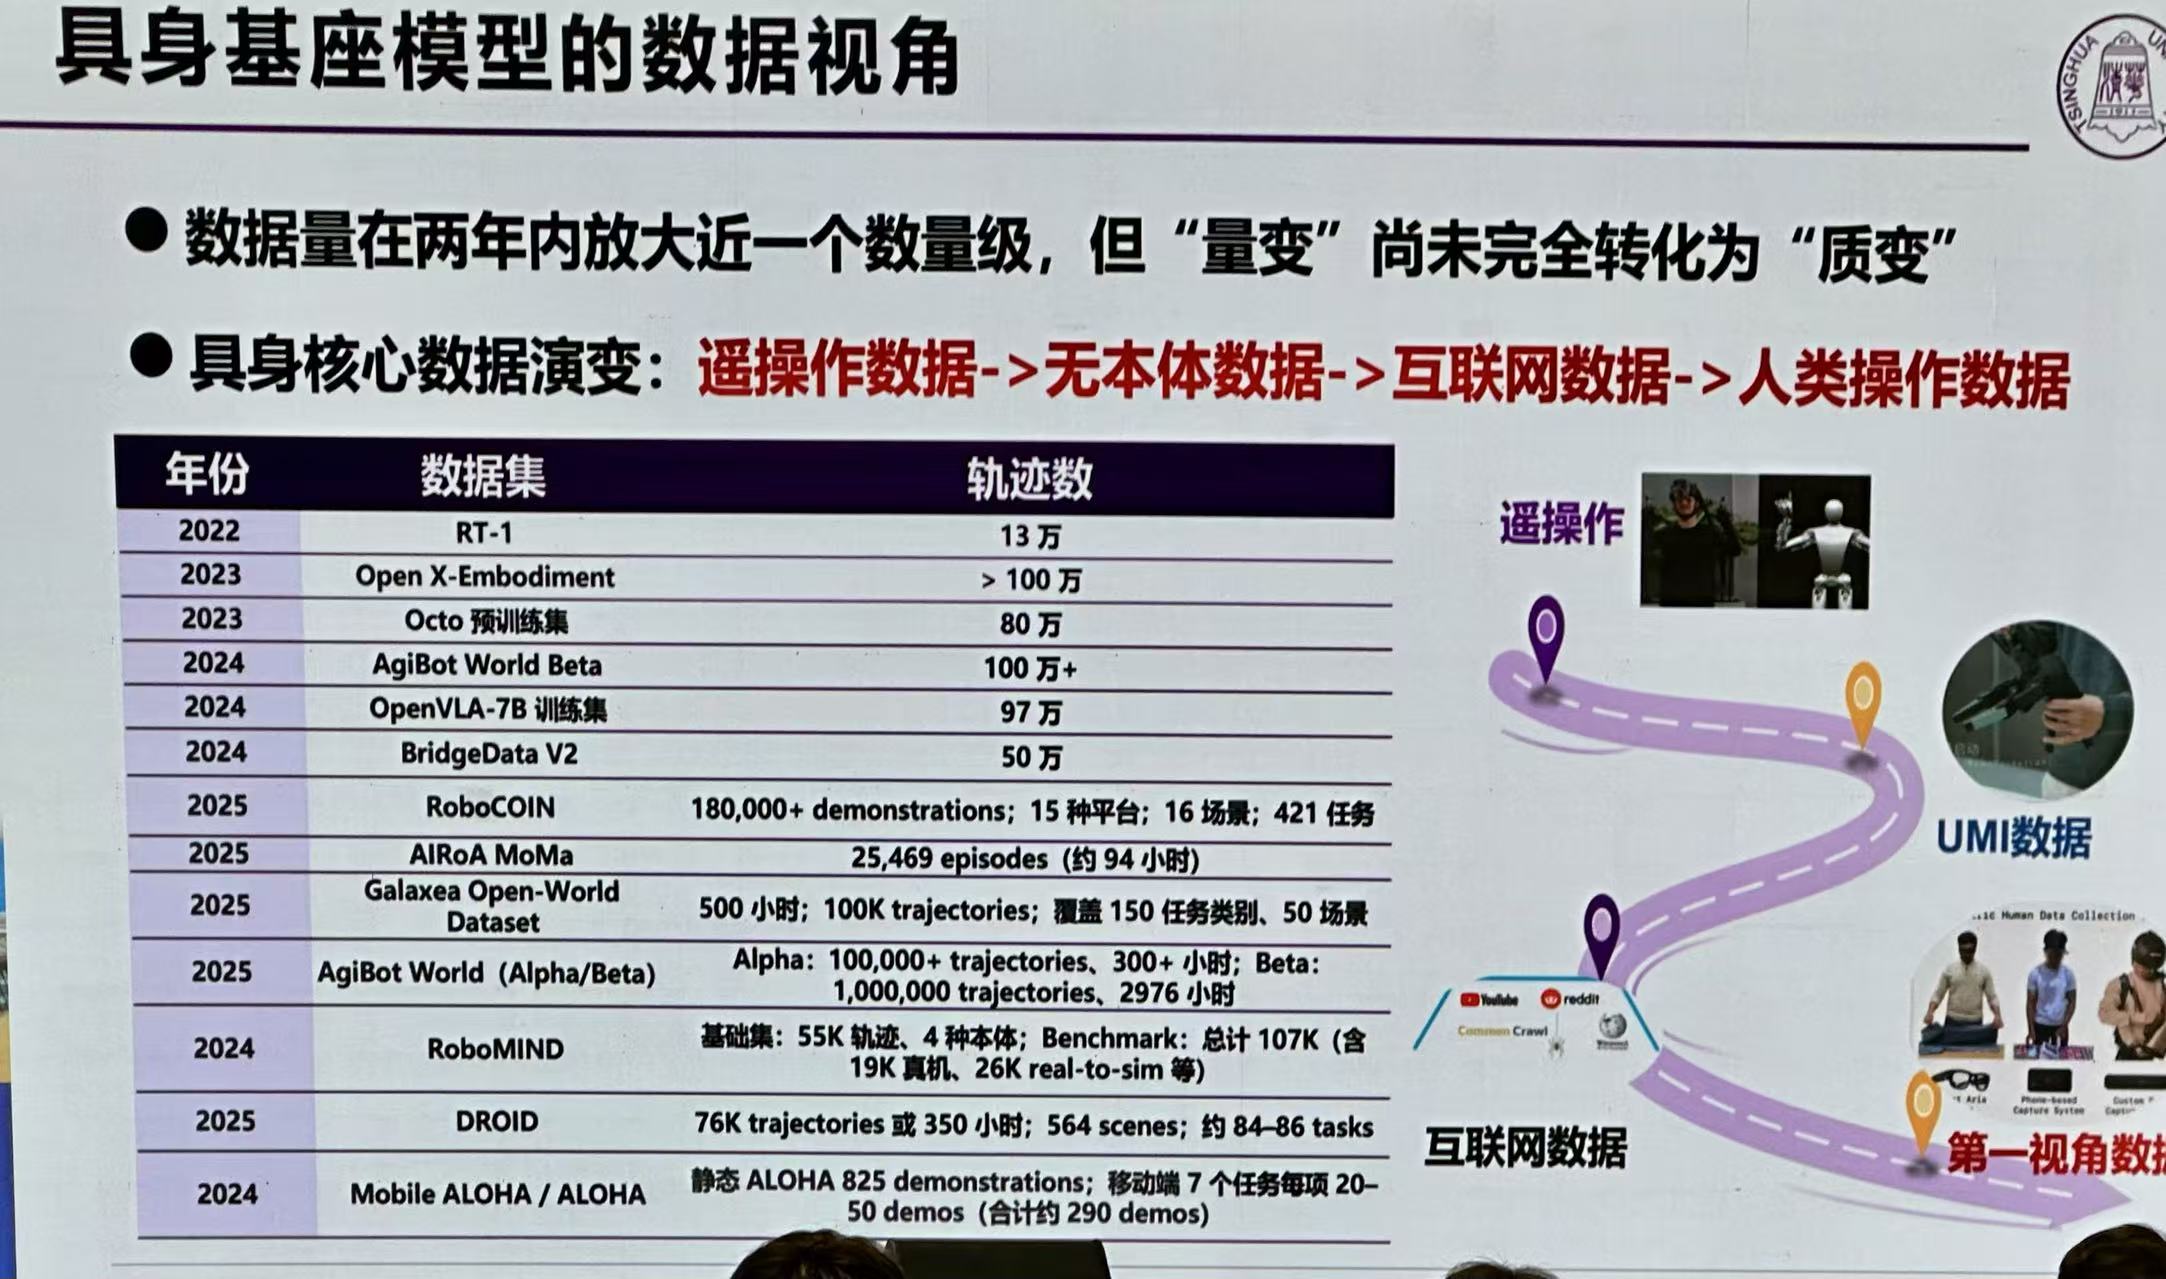
卢宗青(北大 / BeingBeyond)— 人类中心的机器人
利用人类 POV 视频训练具身基础模型。
工作:
- Being-H0 和 Being-H0.5:数据从 3000 小时扩大至万小时,发现了跨本体零样本能力;
- Being-H0.7:端侧实时隐世界–动作模型。
苏航(清华)— 视频数据驱动的具身基座模型
工作:Motus,联合预测未来状态和动作。
认为单纯视频数据不够,未来需要真实交互数据的闭环。
穆尧(上交 ScaleLab)— 生成式具身仿真
工作:RoboEvolve 平台,包含:
- Rein3D:场景生成;
- MainTwin:多样化资产生成;
- RoboTwin 3.0(arXiv:2504.13059,CVPR 2025 Highlight):仿真引擎,支持螺纹、流体、柔性物体。
另有 MM-ACT(语义、世界模型、决策基座)、新 VLA 算法、RoboClaw(长程具身 Agent)、HiVLA(层次化精细 VLA)。
仉尚航(北大 HMI Lab)— 具身快慢分层系统
工作:RoboBrain 系列(大脑层),以及:
- WoW:生成机器人操作视频;
- LaST0:思维链基座模型;
- TwinRL:数字孪生自进化。
未来:统一理解与生成的基座模型。
张力(复旦 Logo Robotics Group)— 通用具身智能
认为过去数据驱动方法均采用先验–自回归范式,否定 GPT 式的预训练 Scaling 路线,因为所需数据量可能相当于整个世界。
吴佳俊(斯坦福)— 视觉智能与物理参数
视觉到物理参数本质上是渲染的逆过程。
思路:
- 通过监督归纳性偏置:发现同类物体共享形状与材质分布,只要建模物理分布即可从单图学习——由单类到多类,NeuROK 从静态物体归纳形变,Encoder-Decoder 框架对较差 Mesh 也有效。缺点:模拟器须可微、准、快,因此需要假设限制。
- 生成模型蒸馏式训练物理参数:可蒸馏出 Birth and Death of a Rose(形变)、Object Flow、PhysDreamer(arXiv:2404.13026,ECCV 2024)(物理)、3D 流体、WonderPlay 和 RealWonder(含 Action)。
问答:玫瑰论文是在用物理解释”玫瑰是什么”,MCP、Skills 其实在做名词的具体解释。
高林(中科院计算所)— 3D 重建与先验
挑战:稀疏视角与高质量重建之间的矛盾。认为引入结构化表征相当于压缩了先验。
工作:
- 单图人手重建:用 NIMBLE 数据集、GaussianMesh 结构化、Deferred Render 可微可重光照;
- 线稿人头生成与编辑;
- 借助 PRoPE 编码相机位姿;
- 计图高斯库。
崔兆鹏(浙大)— 3D 动态建模与物理先验
挑战:不可见场重建(如风场、电磁场)以及重建的实时性。
工作:
- DiffWind:视频–风场重建;
- PhysSkin:用显式低秩形变场。
刘玉身(清华)— 3DGS 重建与生成
工作:
- Neural-Pull:用点云监督 SDF 表面重建,迁移到 GS-Pull,GaussianUDF 开放结构;
- Binocular-GS:用深度提升质量;
- 4C4D;
- MoRe;
- DiffGS:高斯生成,GAP;
- 高精度重建辅助场景测量(需结合激光点云)。
彭思达(浙大)— 深度重建与机器人仿真环境
工作:
- PromptDA:使用前馈高斯;
- InfiniDepth:使用 Implicit Decoder 获取更连续的表示,但多帧一致性差;
- Scal3R:分 Chunk 逐 Chunk 梯度平均;
- Habitat-GS:仿真环境。
另:发起 OnSite 自驾挑战赛。
相里元博(上交)— Robust 在野几何
问题:MegaScene 数据集的 Doppelganger 问题、稀疏视角场景的相机数据不准。
工作:
- MegaDepth-X:识别并重处理了 Doppelganger 情况的相机参数;
- 在稠密视角场景上自行稀疏蒸馏;
- MetricScenes。
连宙辉(北大)— 单目 3D 重建
工作:
- FISHuman:3D 数字人,使用 RGB–法线双路 DiT、4D Remesh、Unified UV Learning;
- Pano2Room;
- ActMVS++:无人机主动场景重建。
郭裕兰(中山大学)
工作:PanMatch。
Andrea Vedaldi(牛津大学)— 3D 对 AI 的影响
工作:
- VGGT(arXiv:2503.11651,CVPR 2025):认为未来属于 3D Transformers,擅长多视角重建、单目深度、2D 特征匹配;
- LargeNVS:Decoder 比 Encoder 更宽,比 VGGT 代表的 Bottleneck 架构更快;
- CoTracker3(arXiv:2410.11831)、CoWTracker;
- Dynamic Point Maps(arXiv:2503.16318):4D Transformers,V-DPM(arXiv:2601.09499);
- VGGT-Omega;
- Particulate:可交互铰链模型。
内容分析与统计
一、报告者统计
本次 China3DV 2026 会议共收录三天报告,合计演讲者约 44 人次(含展台演示 2 个)。
| 日期 | 演讲人数 |
|---|---|
| 第一天(4 月 17 日) | 17 人 |
| 第二天(4 月 18 日) | 17 人 |
| 第三天(4 月 19 日) | 13 人(含展台 2 个) |
二、三维视觉细分方向分布
以下统计基于每位演讲者的主要研究方向归类(部分演讲者涉及多个方向,按主方向计):
| 细分方向 | 报告数 | 代表演讲者 |
|---|---|---|
| 3D 重建(含 SLAM/单目/稀疏视角) | 11 | 张兆翔、吴尚哲、汤思宇、陈宝权、刘烨斌、高林、崔兆鹏、刘玉身、彭思达、相里元博、连宙辉 |
| 机器人与具身智能(含 VLA) | 12 | 苏昊、徐英豪、施柏鑫、张延柏、刘利斌、马月昕、黄思远、Xue Bin Peng、徐凯、卢宗青、苏航、穆尧、仉尚航、张力 |
| 3D/4D 生成 | 8 | 郭春超、周晓巍、陈安沛、杨蛟龙、许岚、张彪、刘缘、虞晶怡 |
| 世界模型与视频生成 | 6 | Gordon Wetzstein、陈宝权、沈春华、谭平、章国峰、王腾飞 |
| 数字人与数字孪生 | 4 | 韩晓光、陈志文、仉尚航(TwinRL)、连宙辉(FISHuman) |
| 多模态大模型(VLM/LLM) | 4 | 刘缘、陈昊、袁粒、黄高 |
| 物理模拟与动力学 | 3 | 吴尚哲、崔兆鹏、吴佳俊 |
| 数据集 | 3 | 刘子纬(Xperience-10M)、姚遥(SpatialVID)、相里元博(MegaDepth-X) |
| 深度估计 | 2 | 沈春华(Depth Any Video)、彭思达(PromptDA) |
| 工业/商业 | 3 | 胡渊鸣(Meshy)、孙建飞(奥比中光)、黄然(华为) |
注:部分演讲跨越多个方向(如沈春华同时涉及重建与世界模型),统计时以其演讲重点归类。
三、关键趋势洞察
世界模型成为核心议题:多位来自顶尖高校和工业界的演讲者聚焦世界模型,但路线之争明显——视频生成派(Sora-like)与 3D 表征派仍在博弈,两者融合成为新方向。
具身智能热度持续飙升:三天议程中具身智能相关报告占比约 27%,涵盖 VLA、灵巧手、人形机器人、数据采集、仿真平台等完整链条,呈现出从感知到行动的全链条研究态势。
前馈模型成为 3D 重建新范式:VGGT、SLAM3R、NeoVerse 等前馈重建模型在效率和泛化性上已超越传统优化方法,成为主流方向,但其与生成先验的结合仍是开放问题。
3D 生成走向实用化:从 TRELLIS、CLAY 到混元 3D,3D 生成模型的参数规模、输出质量和工业落地能力均大幅提升,但数据瓶颈和 Scaling 路线尚未明朗。
数据驱动成共识,数据质量是瓶颈:多位演讲者指出 3D/4D 数据的稀缺性是制约模型 Scaling 的根本问题,从游戏数据、卫星图到 POV 视频,各方都在尝试突破数据获取瓶颈。
医学与大规模场景重建是重要应用:ETH Zurich 的 4D 手术孪生和北大的卫星图城市重建均展示了三维视觉技术在专业领域的落地潜力。
多任务统一模型兴起:沈春华(深度+生成+重建)、Andrea Vedaldi(VGGT 系列多任务)等演讲者均强调多任务统一模型的效率优势,是未来方向之一。
猫才毛
Live for what I love ~