写在前面的
本学期以数据结构这门课为契机实现了不少数据结构,也算是一种码力的积累叭。下面列出已实现的和将来需要实现的两部分,比较重要的数据类型会给出api。
已实现的
1. 列表
- 顺序表有一个比较重要的优化点是空出列表地址为0的位置作为“哨兵位”,这样查找时先把需要查找的元素放到“哨兵位”上,接着从后往前依次查找,如果没有找到就会返回0,确保不会越界。此外,doubleSpace函数的写法也要熟练。
- 链表似乎没有什么好说的,双链表通过判断查找元素位于列表前后部来优化查找时间。
字符串使用顺序表来实现,关于模式匹配有两个比较重要的算法:
- BF算法:逐次移动模式首位下标,每次移动后逐个检查模式每位。最差时间复杂度为O(n)。
KMP算法:若逐位比较模式不成功,跳过匹配成功的主串字符,失配函数
KMP算法 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46/*找每一位的最长前缀,前缀:首尾相同的部分,abjab中最长前缀为ab*/
int* nextValue(const sstring &t) {
int tlen = t.length();
int *next = new int[tlen];
int iterator, len, str_pointer, maxLen;
for (iterator = 0; iterator < tlen; iterator++) {
maxLen = 0;
for (len = iterator; len > 0; len--) {
maxLen = len;
for (str_pointer = 0; str_pointer < len; str_pointer++) {
if (t.str[str_pointer] != t.str[iterator - len + str_pointer])
{maxLen = 0; break;}
}
if (maxLen) break;
}
next[iterator] = maxLen;
}
return next;
}
/*每次发生失配时,模式指针回退到最长前缀的下一位,拟成功匹配位置为现主串指针位置 - 最长前缀长度*/
int sstring::KMP_find(const sstring &t, int start) const {
int *next = nextValue(t);
int tlen = t.length();
int truelen = length() - tlen;
int pos;
int iterator = start, substr_pointer = 0;
while (iterator <= truelen) {
pos = iterator;
while ((substr_pointer < tlen) &&
str[iterator] == t.str[substr_pointer]) {iterator++; substr_pointer++;}
// 处理两种情况
// 第一种是substr_pointer == tlen,即匹配成功;
// 另一种情况是匹配出错,substr_pointer回退,iterator进一位;
if (substr_pointer == tlen) {
break;
}
else {
substr_pointer = next[substr_pointer];
iterator++;
}
}
稀疏矩阵
- 矩阵形式
- 链表形式:转置后若要将链表以行列顺序排列,可以以行、列顺序比较进行排序
2. 栈和队列
- 顺序栈和链式栈都比较容易实现
顺序循环队列,下面几个元素比较重要:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class seqQueue {
private:
/*每次pop时,Front前进一位且%maxSize;
*push时,Rear前进一位且%maxSize;*/
int maxSize;
int Front, Rear;
void doubleSpace();
}
template<class elemType>
void seqQueue<elemType>::doubleSpace() {
elemType *newArray;
int i, j;
newArray = new elemType[2*maxSize];
for (i = 0, j = Front; j != Rear; i++, j=(j+1)%maxSize)
newArray[i] = array[j];
delete [] array;
array = newArray;
Front = 0;
Rear = j;
maxSize *= 2;
}优先队列:使用最小化堆或最大化堆来构筑,每次pop只需要除去顶端元素,push时就需要对堆进行调整,由于顶端位置永远为下标0,所以不需要使用循环队列。
priorityQueue.h 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65template <class T>
class priorityQueue {
private:
void adjust(int i);
public:
priorityQueue(T a[], int n);
void enQueue(const T &x);
void deQueue();
};
template <class T>
priorityQueue<T>::priorityQueue(T a[], int n) {
int i, j;
T temp;
array = new T[n + 10];
maxSize = n+10;
Rear = n - 1;
for (i = 0; i < n; i++) array[i] = a[i];
for (i = (n-1)/2; i>=0; i--) {
adjust(i);
}
}
template <class T>
void priorityQueue<T>::enQueue(const T &x) {
if (isFull()) doubleSpace();
Rear++;
int hole; // 从队尾开始,寻找插入元素最合适的位置,每次都只需要与父节点进行比较
for (hole= Rear; hole > 0 && x < array[ hole/ 2 ]; hole /= 2 )
array[ hole ] = array[ hole / 2 ];
array[hole] = x;
}
template <class T>
void priorityQueue<T>::deQueue() {
if (isEmpty()) throw outOfBound();
// 把队尾元素放到首位,然后调整
array[0] = array[Rear];
Rear--;
adjust(0);
}
template <class T>
void priorityQueue<T>::adjust(int i) {
int maxChild;
T temp;
// 调整小的往上,小顶堆
while (true) {
maxChild = 2*i+1;
if (maxChild > Rear) return;
if (maxChild+1 <= Rear) {
if (array[maxChild + 1] <= array[maxChild]) maxChild++;
}
if (array[i] < array[maxChild]) return;
temp = array[i];
array[i] = array[maxChild];
array[maxChild] = temp;
i = maxChild;
}
}
3. 树和二叉树
- 二叉树
- 满二叉树或完全二叉树可以使用数组来构筑。
- 三种遍历方式都需要用到栈,其中只有前序遍历不需要额外的辅助标记栈。
- 二叉线索树通过对非满节点的孩子命为直接前驱或直接后继,摆脱了中序遍历时对栈的依赖。
- 哈夫曼树的构建:总结点数为原结点数的2n-1倍,每次把最小的两个权重加和构筑新结点并作为它们的父结点。
- 并查集以根节点为特征,每个节点都有一个父节点字段,根节点的父节点为不存在的位置如-1,可以用数组构建。
- 树与二叉树转换:二叉树可以通过孩子兄弟表示法来表示树,该算法中每个二叉树节点的字段有树中该节点的第一个孩子、数据和下一个兄弟节点。
4. 图
- 邻接矩阵
- 邻接表
- 标准形式,有个小窍门是每次插入新边时插到离节点最近的位置,使时间复杂度减为O(n),但对于邻接多重表和十字链表显然不适用
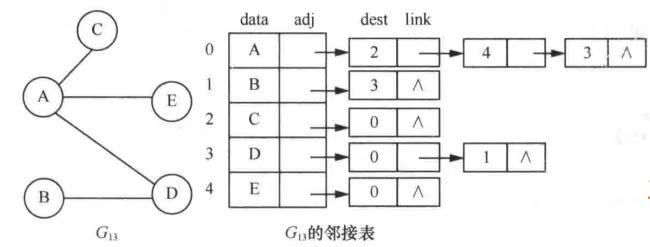
邻接表表示 - 邻接多重表
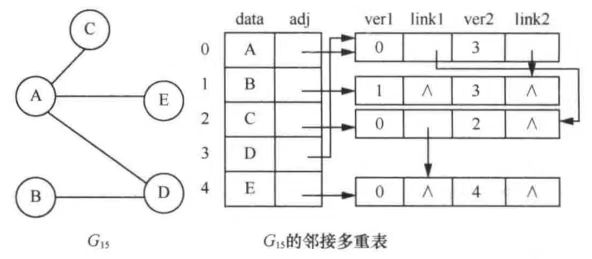
邻接多重表表示 - 十字链表
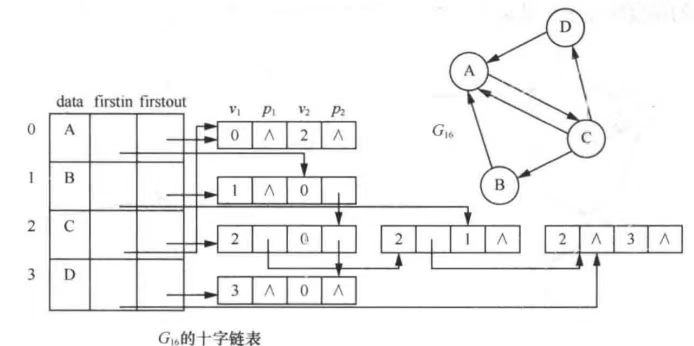
十字链表表示
- 标准形式,有个小窍门是每次插入新边时插到离节点最近的位置,使时间复杂度减为O(n),但对于邻接多重表和十字链表显然不适用
- 遍历方式
- 深度优先遍历BFS:用栈,先访问先进节点的邻节点。
- 广度优先遍历DFS:用队列,先访问邻节点。
5. 其他
- 哈希集合:顺序表,插入位置由
待插入数据 % 质数计算得到,每个位置存储一个链表的首节点。
未实现的
平衡二叉树(AVL)、红黑树、B树、B+树…
猫才毛
Live for what I love ~
24
8
5