从三维真实世界的二维投射中恢复三维结构和语义。
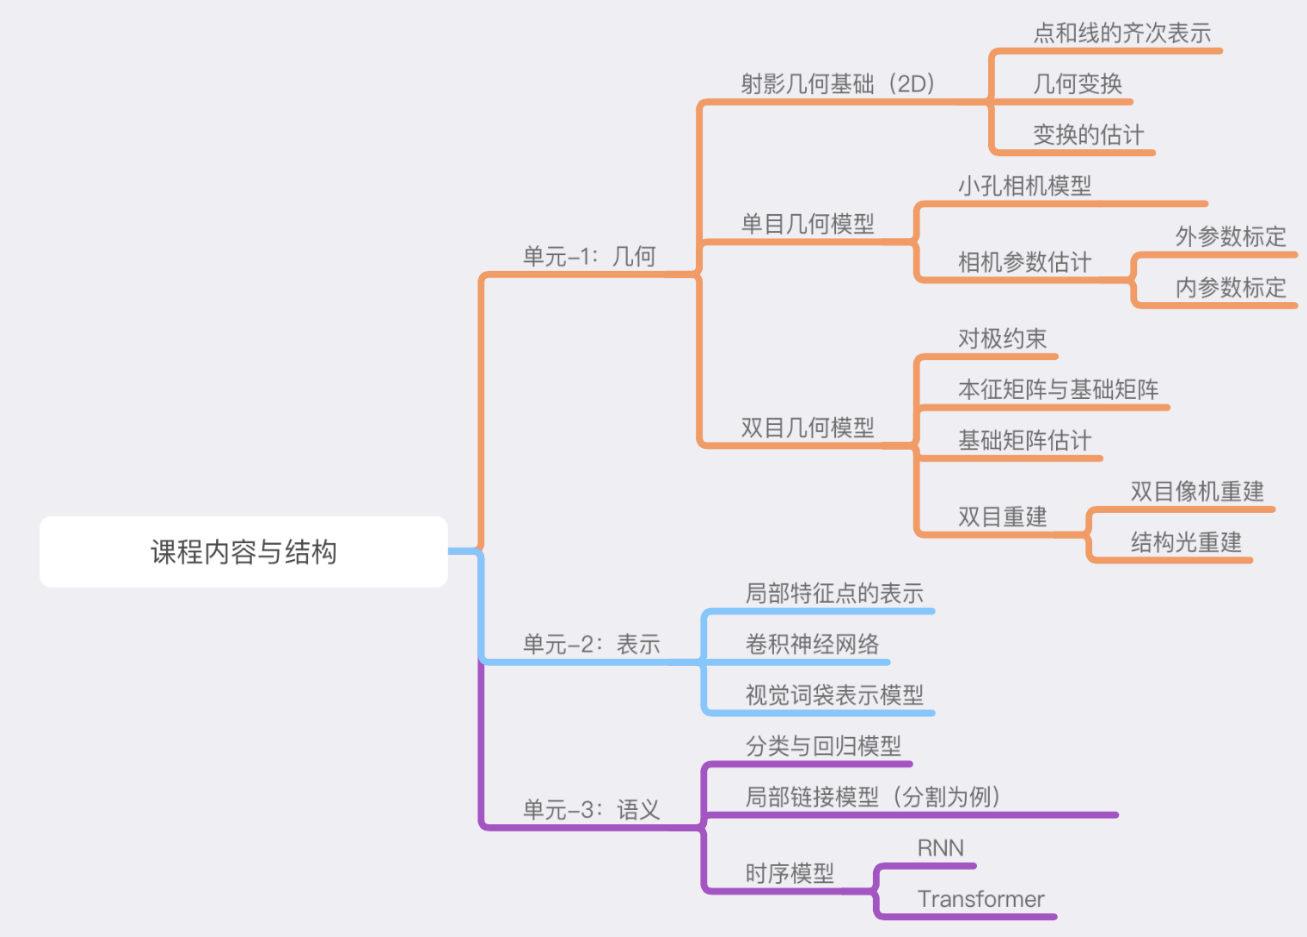
射影几何与变换
2D射影几何基础
- 平面点:$\boldsymbol{x}=(x,y)^T$-列向量
平面线:$ax+by+c=0$,$\boldsymbol{l}=(a,b,c)^T$-线的向量表示,张成2D射影空间$\mathbb{P}^2$
点在线上$(x,y,1)(a,b,c)^T=(x,y,1)\boldsymbol{l}=0$,点有齐次表示$\boldsymbol{x}=(x_1,x_2,x_3)^T\in \mathbb{P}^2$。点的自由度为2,只有前两位有意义。齐次坐标使得非线性映射可以用矩阵表示,以及很好表示无穷远点和线。
$\begin{aligned}\boldsymbol{u}&=(u_1,u_2,u_3)^T,\boldsymbol{v}=(v_1,v_2,v_3)^T \\
\boldsymbol{u}\times \boldsymbol{v}&=(u_1\boldsymbol{i}+u_2\boldsymbol{j}+u_3\boldsymbol{k})\times(v_1\boldsymbol{i}+v_2\boldsymbol{j}+v_3\boldsymbol{k}) \\ &=(u_2v_3-u_3v_2)\boldsymbol{i}+(u_3v_1-u_1v_3)\boldsymbol{j}+(u_1v_2-u_2v_1)\boldsymbol{k}
\end{aligned}$两条线的交点$\boldsymbol{x}=\boldsymbol{l}\times\boldsymbol{l}’$。
- 过两点的直线$\boldsymbol{l}=\boldsymbol{x}\times\boldsymbol{x}’$。
- 无穷远点(平行线$(a,b,c)^T,(a,b,c’)^T$)$(b,-a,0)^T$。
- 无穷远线$\boldsymbol{l}_\infty=(0,0,1)^T$。
- 点和线有对偶关系$\boldsymbol{l}^T\boldsymbol{x}=\boldsymbol{x}^T\boldsymbol{l}$。
射影变换
射影变换:$\mathbb{P}^2\rightarrow\mathbb{P}^2$
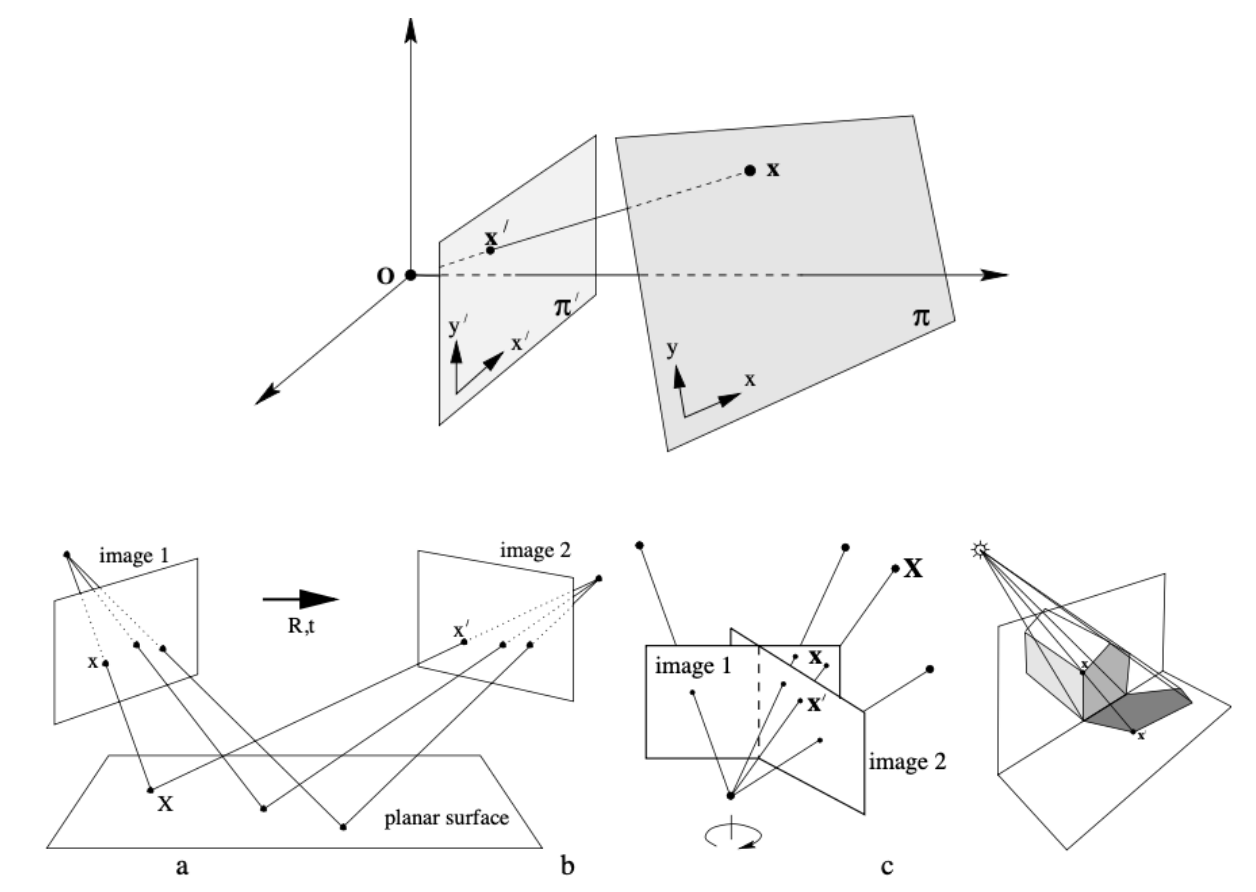
- 共线性:共线的3个点变换后也共线;
- 可逆性:变换的逆也是射影变换;
- 组合性:射影变换的组合仍是射影变换。
- 定理:单应(homography)当且仅当存在$3\times 3$非奇异矩阵$H:h(\boldsymbol{x})=H\boldsymbol{x}$
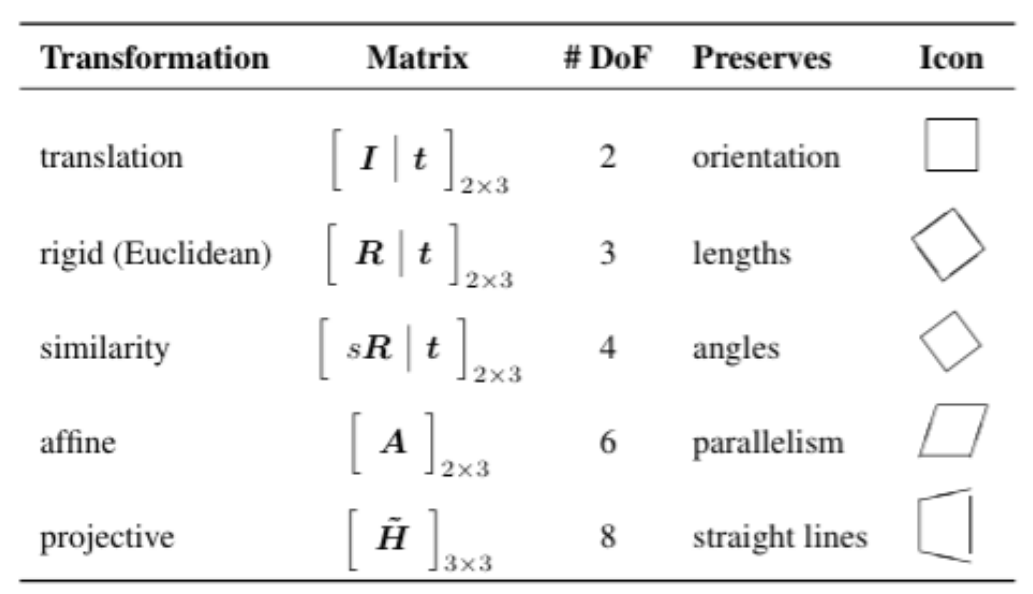
- 变换层次:欧几里得变换$\rightarrow$相似变换$\rightarrow$仿射变换$\rightarrow$射影变换
- 欧几里得变换
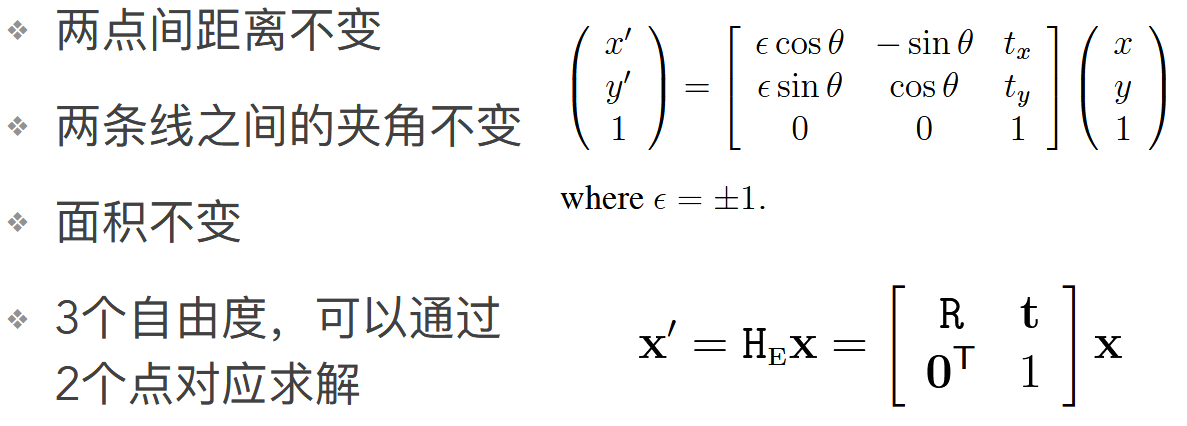
- 相似变换
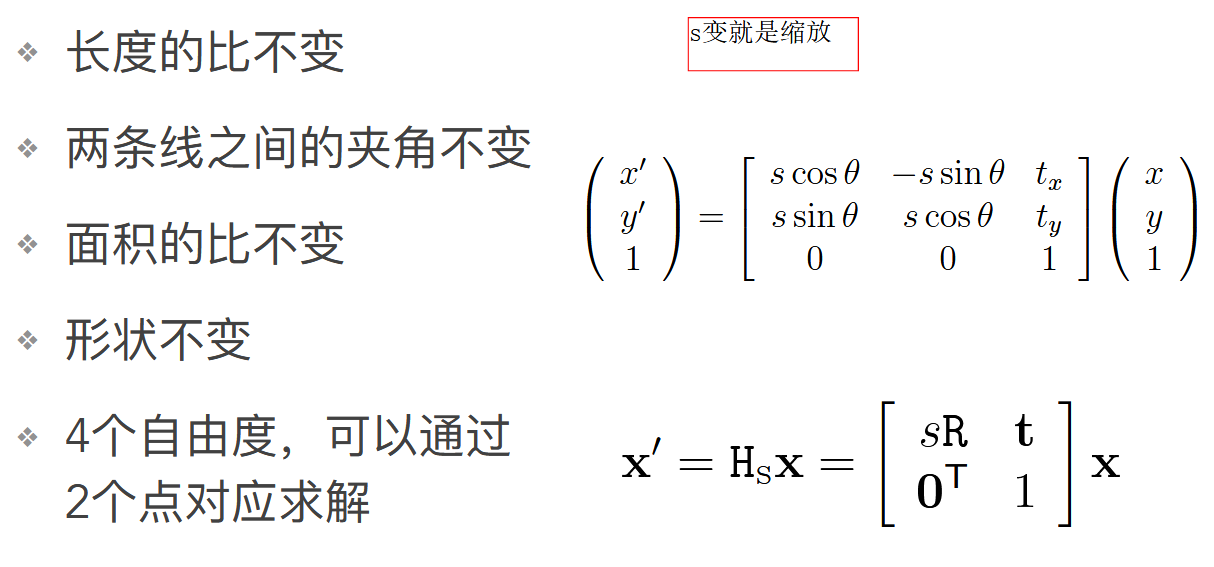
- 仿射变换
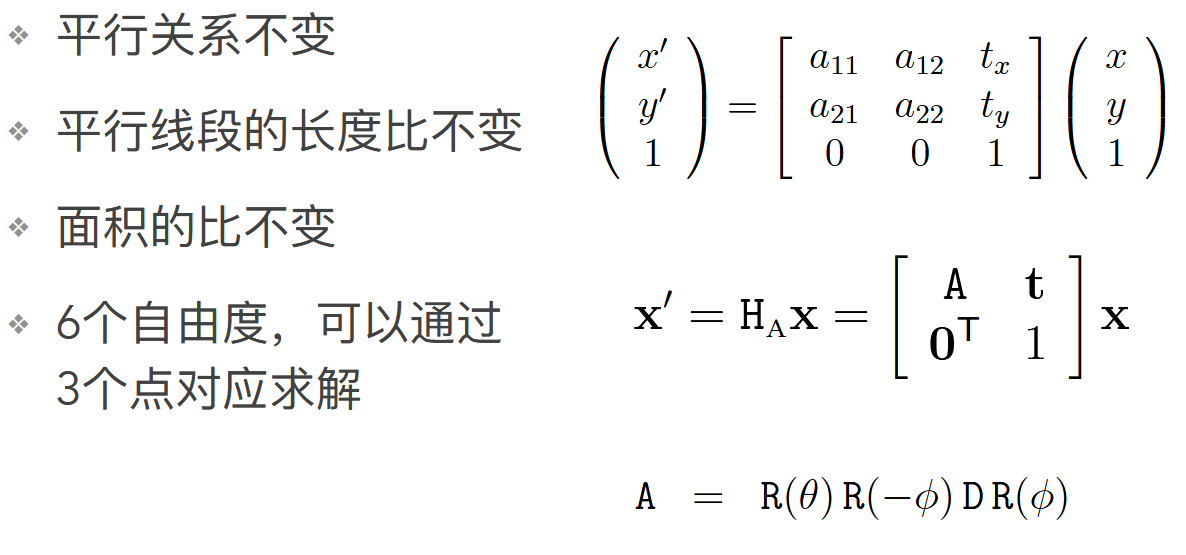
- 射影变换
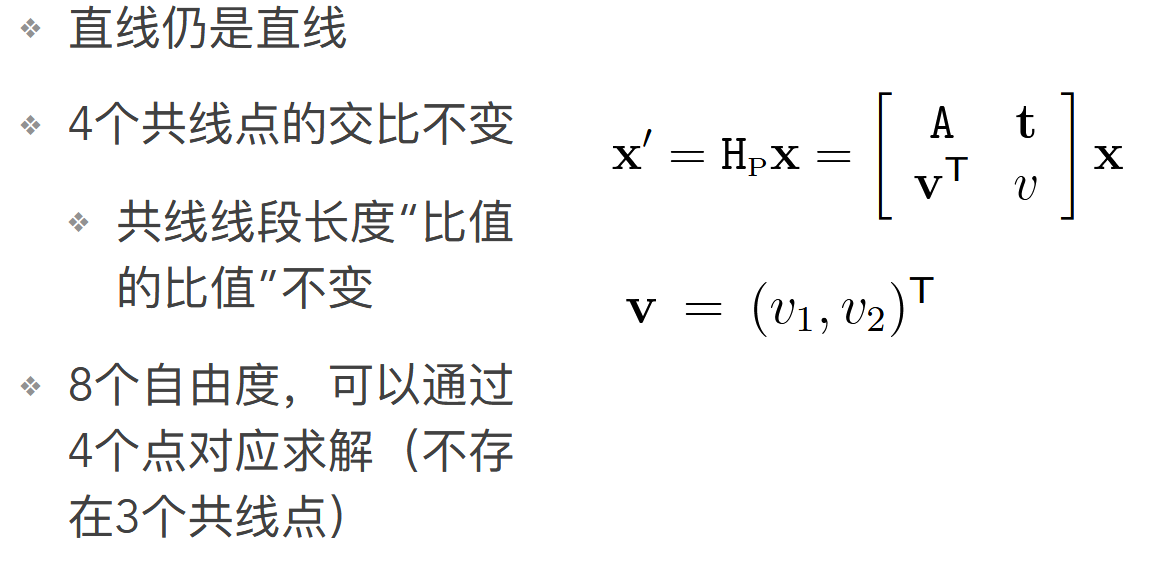
- 总结
- 欧几里得变换
2D射影变换估计
- 求解射影变换H的最小配置解需要2张变换图像的4组对应点。
直接线性变换算法(DLT):
- 为规避变换前后点的尺度问题,方程表达为$x_i’\times Hx_i=0\rightarrow A_ih=0\; A_i$为$2\times 9$或$3\times 9$矩阵。其中$h=(H_{11},H_{12},H_{13},…,H_{33})$,由于可以将$H_{33}$标准化为1,或者引入尺度约束$||h||=1$,我们只需要4对二维点8个方程进行求解(最小配置解)。
- 超定解:点对大于4时,可以解优化问题$min||Ah||\;subject\;to\;||h||=1$。
算法:计算每对点的矩阵$A_i$,将每个$2\times 9$矩阵组合成一个$2n\times 9$的矩阵$A$。对$A$进行奇异值分解,最小奇异值对应的单位特征向量就是我们需要的解。
设$M$为m行n列矩阵,其奇异值分解为,其中$U$为m行m列幺正矩阵(其共轭转置等于其逆),$\Sigma$是m行n列非负实数对角矩阵,$V$为n行n列幺正矩阵(为其共轭转置)。奇异值$sigma$满足,u是$\sigma$的m维单位向量(左奇异向量),v为n维归一化的右奇异向量。$\Sigma$对角线上是M的奇异值,而$U、V$的列分别是左、右奇异向量,同时也分别是的特征向量。
归一化DLT:进行DLT前先计算相似变换$T$和$T’$分别使x点集、x’点集的中心位于原点,且到原点的平均距离为$\sqrt{2}$。常规DLT得到单应矩阵$\overline{H}$,再解除归一化$H=T’^{-1}\overline{H}T$。
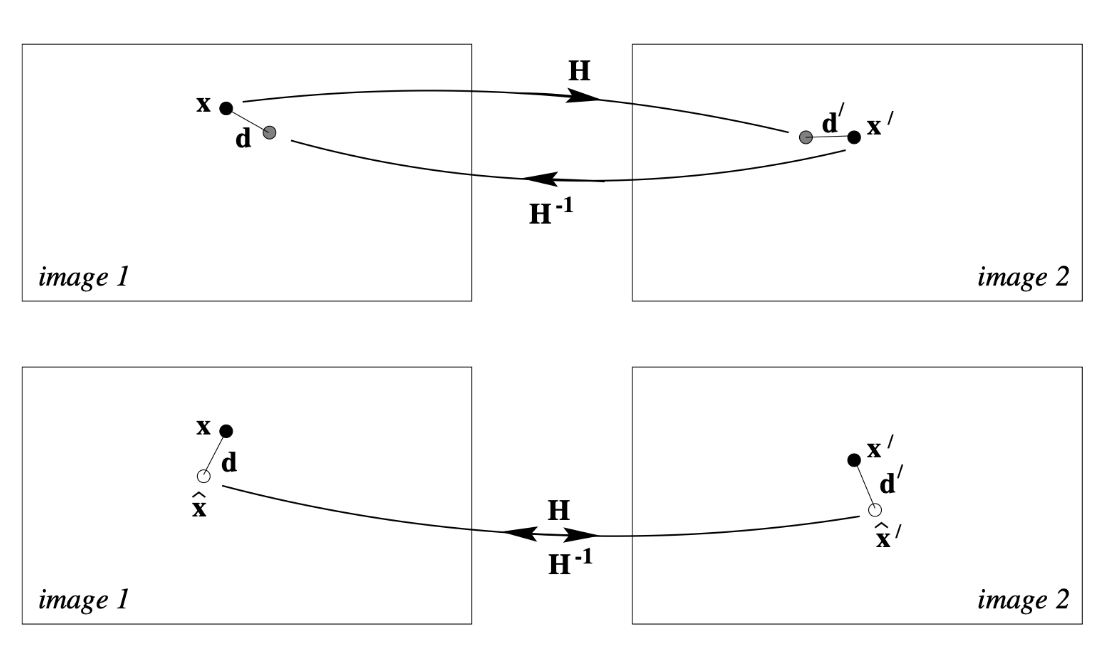
迭代优化算法:最小化误差函数(代价函数)来减小测量误差带来的错误,下面是几种典型的代价函数
- 代数距离,如各点误差平方之和;
- 几何距离,如距离平方之和;
重投影误差,两幅图上各测量点投影到到真实点的误差,过程中同时优化两幅图上的测量点和单应矩阵。常见的误差的度量方法有均方根、平均值或中位数等。采用该误差的方法有Sampson error和Gold Standard error等。
摄像机及其几何模型
单目几何模型
- 小孔模型:让所有光线只能通过唯一的孔进入暗室到达胶片,消除了模糊。
- 光线进入的通道就是光圈,数值上为焦距 / 针孔直径。
- 小孔与成像面的距离,称为焦距,常用单位为毫米或英寸。焦距较小可拍摄广角照片,较大则为长焦照片。
- 小孔小到一定程度会因为衍射导致模糊。
- 小孔的最佳直径$\phi=\sqrt{2f\lambda}$。
- 暗角是因为小孔与相纸四角的距离较远,解决方法之一是将相纸卷曲成椭圆面。
- 小孔相机有无限景深,即不论远近的物体清晰度相同,但是容易出现眩光。
- 透视投影效应
- 近大远小:相似三角形原理,靠近小孔的小物体和远离小孔的大物体在相纸上的投影可能同样大。
- 透视投影几何
- 光线上的空间各点投影为同一图像点,物体间有遮挡。
- 点$\rightarrow$点,线$\rightarrow$线或点(经过焦点的线),平面$\rightarrow$平面或线(经过焦点的平面)。距离和角度都可能变化。
- 透视投影方程:$(x,y,z)\xrightarrow{投影变换}(f\frac{x}{z},f\frac{y}{z})$,可以写成齐次矩阵形式,透视投影矩阵可以分解成三个阶段,世界到相机坐标系、透视投影矩阵、相机到像素坐标系。
- 投影分类:
- 透视投影
- 弱透视投影:深度不同的点赋予同样的深度,正常透视投影,即透视投影方程中的$z=z_0$。
- 正交投影:焦点在无限远处,又称平行投影。$(x,y,z)\xrightarrow{正交投影}(x,y)$。
- 透镜模型
- 透镜将平行光经过偏曲(除了经过镜头中心的)后汇聚于焦点。相比小孔模型能聚焦更多的光线。
- 薄透镜的厚度可以忽略。
- 薄透镜方程:$\frac{1}{f}=\frac{1}{u}+\frac{1}{v}$。
- 景深:不同深度的景物点会聚焦到不同的图像平面,不在成像平面上的聚焦点会投影成一个模糊的圈。景深就是模糊度在容忍范围内的图像平面的距离,景深大即容忍距离大,反之即小。一般光圈越小,聚焦较清晰的范围就越大。
- 通过同一视点不同焦距的照片可以通过优化获得三维深度图。H. Jin and P. Favaro, 2002
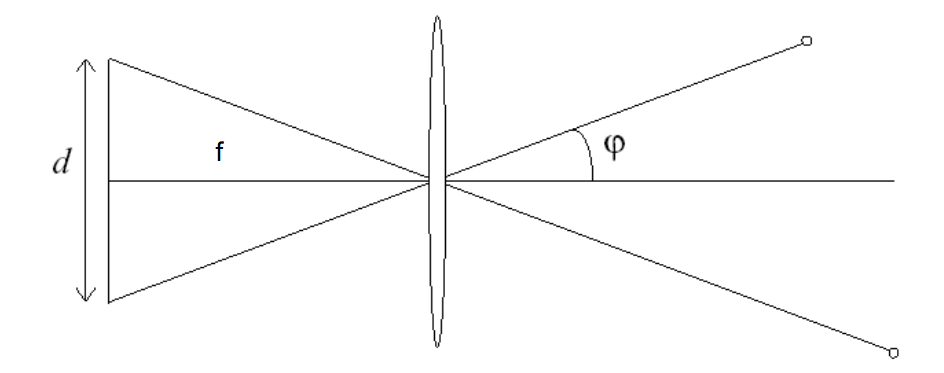
- 视场(Field of View):相机能够看到的角度。因为成像平面大小不变,焦距越小,视场越大;反之越小。满足$\psi=\tan^{-1}(\frac{d}{2f})$。
- 镜头的缺陷
- 色差:镜头对不同波⻓的光线有不同的折射率,导致彩色边纹。
- 球面像差:球状镜头不能完美聚焦,远离光轴的光线聚焦到更近的地方。
- 晕影:镜头组中,靠近成像平面的透镜可能将其他光线投影到原本物体的成像点。
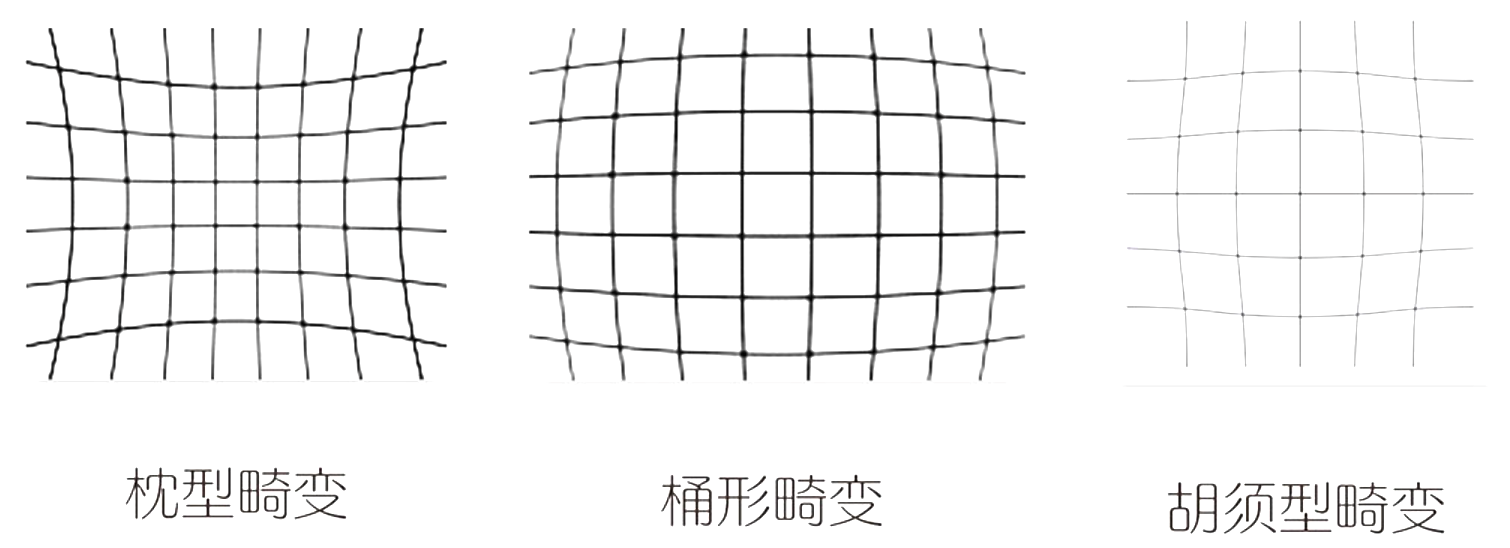
- 径向畸变:
- 广角镜头或者极短焦距情况下容易出现桶装畸变。这是因为物体影像的放大率相对透镜光轴的距离反相关减少。
- 较旧的远摄镜头可能出现枕状畸变。这是因为物体影像的放大率相对透镜光轴的距离正相关增加。
- 变焦镜头的视野末端可能出吓吓你胡状畸变。是前两种的混合,通常是靠近影像中心处为桶状,往外慢慢变成枕状。
- 切向畸变:镜头中物理透镜未完全与成像平面平行。
- 数码相机的数字图像失真:
- 噪声:光线暗或光纤敏感度ISO增加时的噪点(通常可近似为高斯噪声)、坏点。
- 图像处理:过度锐化的光晕、压缩失真、散焦效应。
- 颜色失真:紫晕、白平衡。
- 摄像机模型
- 在透视投影方程的基础上,考虑将坐标转换为数字图像平面的坐标,即原点在图片的左下角,且x、y方向像素数可能不同,则$(x,y,z)\xrightarrow{摄像机变换}(m_xf\frac{x}{z}+p_x,m_yf\frac{y}{z}+p_y)$,这里$m_x,m_y$分别为x、y轴单位距离上的像素数,可以用$\alpha$代替$mf$,$K$为相机内参数矩阵,
- 考虑偏斜时,总自由度为5
- 将物体从世界坐标系转换到相机坐标系的矩阵为相机外参数矩阵,其中$R$为旋转矩阵,$\widetilde{C}$为平移向量,即
- 相机矩阵为3乘4齐次矩阵,且左三列3乘3矩阵非奇异相机中心$C$,则$PC=0$。
- 相机矩阵P的计算,相机的标定就是得到P\相机的内外参数的过程
- 最小配置解:$x_i=PX_i\rightarrow Ap=0$其中$p$为P的12个元素,自由度为11,A为$2n \times 12$矩阵,因此最小配置解需要5.5对点。之后进行SVD分解,最小奇异值对应的右奇异向量就是p。
- 前面提到过的黄金标准算法(Gold Standard error)等。
- 畸变矫正:常用Brown-Corady模型建模相机畸变,并且直接在图像平面上进行去畸变,具体来说其中$(x_d,y_d),(x_u,y_u),(x_c,y_c)$分别为有畸变、去畸变和畸变中心的坐标,$K_n,P_n$分别为径向、切向畸变系数,$r^2=(x_d-x_c)^2+(y_d-y_c)^2$即像素坐标到畸变中心的距离半径的平方。
双目与对极几何模型
- 双目系统的几何结构
- 基线(Baseline):两个光学中心的连线。
- 对极点(Epipole):基线与图像平面的交点。
- 对极平面(Epipolar plane):包含基线的平面。所有对极线在对极点交汇。
- 对极线(Epipolar line):对极平面与图像平面的交线。
- 双目系统的几何约束
- 基本矩阵F
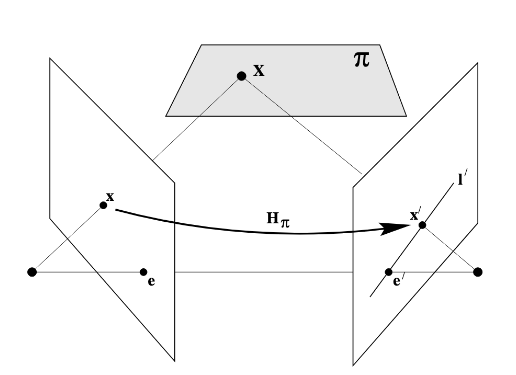
- 描述:F表示对极几何中点与对极线的对应,即上图中$x\xrightarrow{F} l’$。
- 几何推导:如上图,假设在相机坐标系下,有转换关系$x’=H_{\pi}x$,故对极线与对极点则有$l’=e’\times x’=[e’]_{\times} H_{\pi} x=Fx$,$F=[e’]_{\times}H_{\pi}=e’\times H_{\pi}$即基本矩阵。
$[e’]_{\times}$定义为形如
的负对称矩阵,与它相乘相当于与e’叉乘(Multiple view geometry in cv P581)
- 代数推导:$F=[e’]_{\times}P’P^+$,$P^+$是P的伪逆矩阵。假设已知原点在左边相机中心$P=K[I|0],\;P’=K’[R|t]$,则$P^+=\begin{bmatrix}[K^{-1} \\ 0]\end{bmatrix}\; C=(0^T,\; 1)^T$,有
- 性质:
- 3乘3矩阵,由于$[e’]_{\times}$秩为2,故秩为2,7个自由度。
- $l=F^Tx’$
- 对极约束:x’在l’上:$x’^Tl’=x’^TFx=0$
- $Fe=[e’]\times H_{\pi}e=[e’]\times e’=0$,同理$F^Te’=0$,因此e和e’分别是F和F转置的零空间。
- 本质矩阵E
- 推导:当K已知时,归一化坐标$\hat{x}=K^{-1}x=K^{-1}PX=[R|t]X$。当世界坐标系零点在左相机中心时,归一化相机矩阵$P=[I|0],\; P’=[R|t]$。则该系统的基础矩阵为$E=[t]_{\times}R=R[R^Tt]_{\times}$,又称为本质矩阵。
- 性质:
- 3乘3矩阵,秩为2,5个自由度
- $E=K’^TFK$
- $\hat{x’}^TE\hat{x}=0$
- 基本矩阵F
- 解决问题
- 给定图像中的一个点x,如何约束另一幅图像中的对应点x’:$x’Fx=0$
- 给定一组对应点(x,x’),如何得到P,P’:先用点对应算出基础矩阵,再从基础矩阵中算出P与P’
- 8点法:把对极约束方程写成$Af=0$的形式,对A进行SVD分解,f就是V的最后一列。
- Gold Standard:8点法得到F的初值,最小化重投影误差联合优化空间点X和F
- 前面全已知,计算对应空间点X
- 三角定位:x’与x存在测量误差,因此图像点不满足摄像机投影方程和对极约束,反向射线不会交于一点。
- 直接线性法:$\begin{bmatrix}x\times (PX) \\ x’ \times (P’X)\end{bmatrix}=\begin{bmatrix}xp^3-p^1 \\ yp^3-xp^2 \\ x’p’^3-p’^1 \\ y’p’^3-p’^2\end{bmatrix}X=0$,接着用SVD解。
- 光束法(Bundle adjustment):$Q(a_i,b_j)$是点i在图片j上的预测投影点,d计量其与真实点的欧氏距离。$v_{ij}$表示点i在j上是否能被看到,$a_j$表示相机参数,$b_i$表示点坐标
- 立体视觉深度估计
- 概念
- 深度:摄像机中心导场景点的距离,或者Z坐标分量。
- 立体视觉(Stereo):通过三维点在两幅图像中的位置差异计算场景深度的视觉技术。
- 简单立体视觉系统的几何结构:
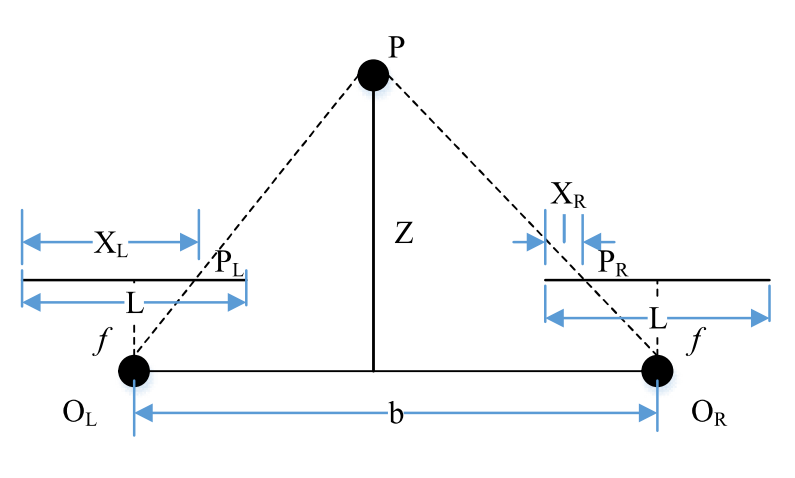
- 目标:假设光轴平行、相机参数已知,希望通过图像坐标点的对应恢复三维点的深度。
- 由相似三角形原理,$Z=\frac{bf}{d}=\frac{bf}{b-X_L+X_R}$
- 对极约束的作用:空间点P与两个相机中心确定了对极平面,P的投影点一定在相机成像平面与对极平面的交线上。这能够缩小对应点的搜索空间。
- 立体视觉图像矫正
- 目的:使光轴平行,且图像平面平行于基线,此时对极线就是图像的一行。需要求出两个图像重投影的单应变换。
- 步骤:将图像2的对极点映射到水平方向的无穷远点(1,0,0)(对应于两图像平面平行)得到变换H’,再用最小二乘法求解图像1的变换H,最终用变换矩阵重采样。
- H’求法:
- H求法:当H与H’相匹配时,由基础矩阵$F=[e’]_{\times}M$,H需要满足
式中$H’e’=(1,0,0)^T$,则$H_A=\begin{bmatrix}a &b &c \\ 0 &1 &0 \\ 0 &0 &1\end{bmatrix},\; H=H_AH’M$ - 最小化视差:$\min_{a,b,c}\sum\nolimits_i d(Hx_i, H’x_i’)^2$
- 立体视觉匹配:利用相似度、唯一性、顺序、视差梯度等软约束找匹配点
- 局部法-密集对应搜索:对于图1对极线上的每个窗口,在图2相同对极线上逐窗口寻找代价最小的位置。代价的一种比较方式是比较窗口向量$w$减去平均值$\overline{w}$后两向量$w-\overline{w},\;w’-\overline{w}’$间的角度,即求余弦值。
- 基于相关的窗口匹配:PPT有点简略,暂时没在书上找到,欢迎在评论区补充。
窗口大小分析:窗口大$\rightarrow$细节少、噪声少;窗口小$\rightarrow$细节多、噪声多。可以改进为自适应的窗口大小。
- 能量最小化问题:找到视差d,使其能最小化能量函数$E(d)=\sum\nolimits_{(x,y)\in I}C(x,y,d(x,y))$。
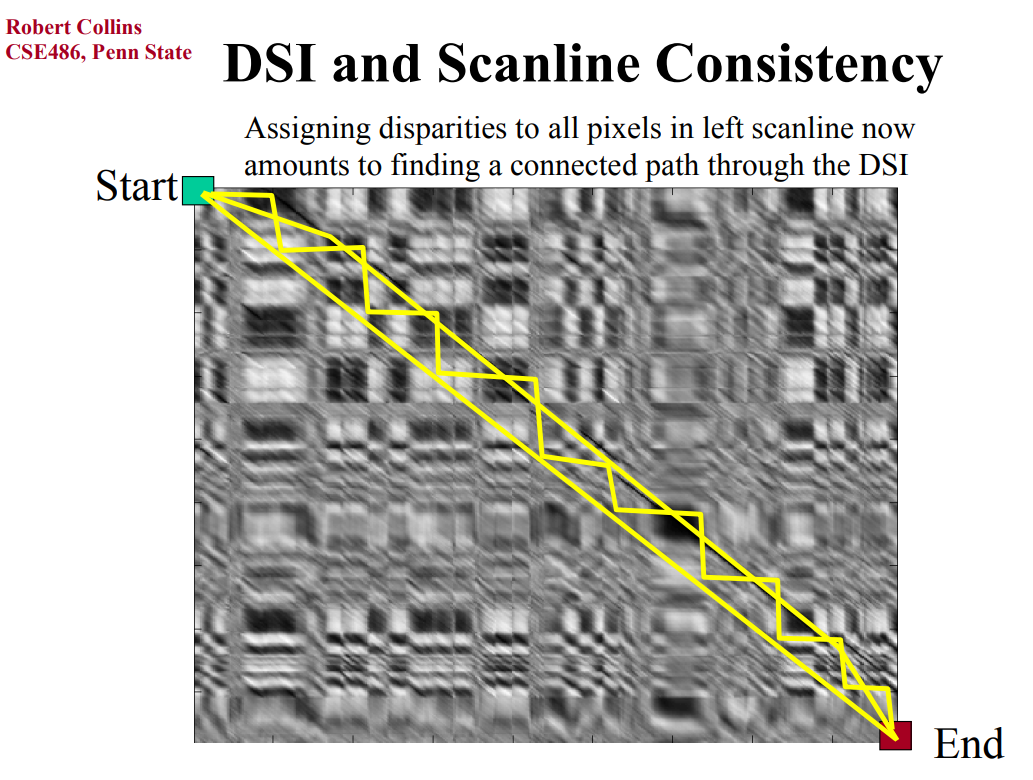
Disparity Space Image(DSI)评价两张图片中某一行每个像素的匹配得分,坐标为(i, j),即同一行左图第i个像素与右图第j个像素的匹配。
- 单像素匹配:在DSI的每一列独立选择最小的匹配方式。
- 平滑匹配:能量函数中除匹配代价外加入平滑代价,如临近4个点的L1视差距离、临近8个点的匹配之和等。
- 扫描线法动态规划:有了DSI,其实每一行的匹配问题就成了找一条从DSI图左上角到右下角的最小代价路径,并且该路径尽量不会造成阻塞(occlusion)。常见算法和阻塞解决办法见Viterbi算法和Stereo Algorithms
- 遮挡问题:可以利用视差梯度约束,顺序约束等
其他挑战性问题:
- 主动立体视觉:结构光,通过将光图案投射到物体表面来测量三维物体形状和深度的方法。图案可以是条纹、网格或点。投影图案的变形通过三角测量揭示物体的立体几何形状,从而创建物体的3D模型。
- 概念
局部特征的检测与描述
检测
- 边缘
- 因素:表面法线、深度、表面颜色、光照不连续。
- 特征:像素值突变,或者进一步导数(差分滤波)先向下突变、再向上突变。
- 问题:
- 噪声:取图像的一行,像素值突变处处都是,差分滤波响应强。解决方法是将图像先通过平滑滤波器(如跟高斯函数卷积),要求差分图像则可以与高斯函数的导数卷积(卷积的导数等于卷积其中一个导数)。
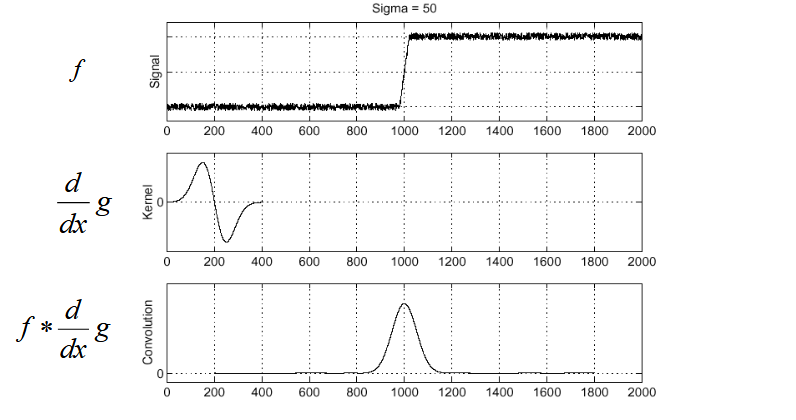
- 平滑求导:去除噪声,但是模糊了边缘。滤波器大小不同也会有不同效果。
- 噪声:取图像的一行,像素值突变处处都是,差分滤波响应强。解决方法是将图像先通过平滑滤波器(如跟高斯函数卷积),要求差分图像则可以与高斯函数的导数卷积(卷积的导数等于卷积其中一个导数)。
- 边缘检测器
- Canny:高斯一阶导数接近优化信噪比和定位乘积算子。高斯滤波核的大小会影响检测边缘的尺度、细节、平滑度。应用广泛。
- 分别用xy方向的高斯滤波器对图像滤波
- 用差分计算梯度的大小和方向,即$E_s,\; E_0$两张图
- 非最大抑制,对每个像素[i, j],确定最接近$E_0[i,\;j]$的$0^o,45^o,90^o,135^o$中的一个方向$d_k$。沿着该方向查看[i, j]的两个近邻,如果$E_s[i,\;j]$大于两个近邻,$I_N[i,\;j]=E_s[i,\;j]$,否则等于0。输出图像$I_N$是细化后的边缘。
- 双阈值边缘连接。选择阈值$T_H, \; T_L$,对每个未处理的边缘点$I_N[i,\;j]$,如果它大于$T_H$就继续沿着边缘追踪;如果它大于$T_L$且与已被处理为边缘的点邻接,就把它也作为边缘点,继续追踪;如果都小于就重新定位。这种方法称为滞后阈值法(Hysteresis thresholding)。
- Laplacian of Gaussian(LoG):用高斯滤波平滑图像,再用拉普拉斯算子增强边缘,最后检测二阶导数的过零点。
- Canny:高斯一阶导数接近优化信噪比和定位乘积算子。高斯滤波核的大小会影响检测边缘的尺度、细节、平滑度。应用广泛。
- 点
- 局部特征的主要部分:
- 用处:通过检测找到一组关键点,以关键点为中心建立局部邻域的向量表示,从而通过计算特征向量的距离找到两幅图中的对应。
- 好的局部特征:
- 重复性——不同图像中有、反复检测到
- 显著性——独特
- 紧凑性——数量少
- 局部性——图像中的一小片区域,对遮挡和复杂背景有鲁棒性
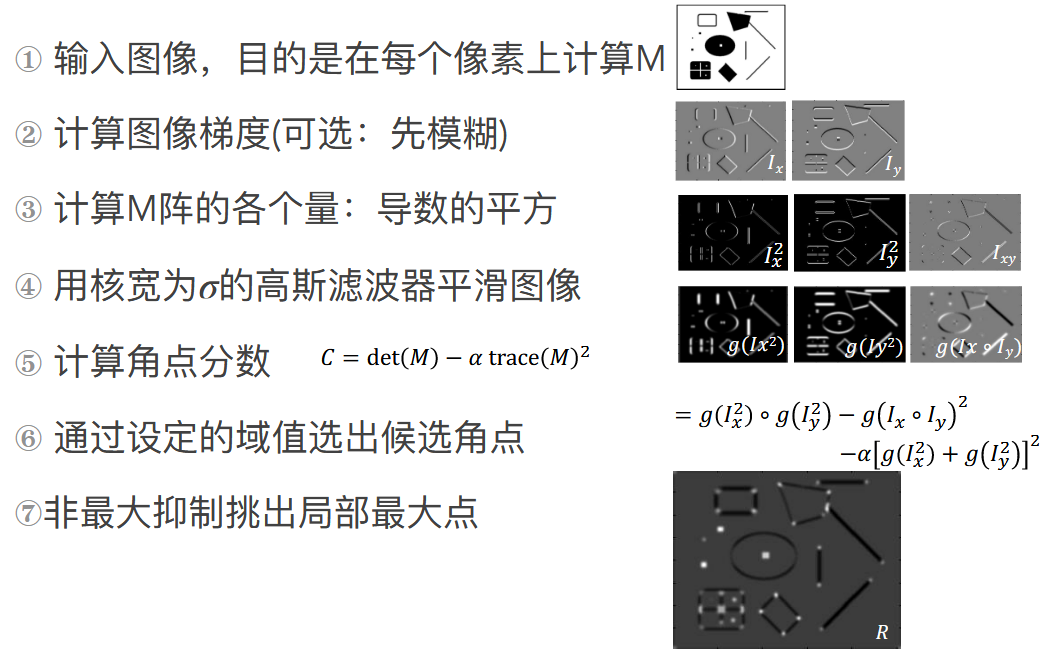
- 角点检测:滑动窗口,包含角点的滑窗向任何方向移动都会引起灰度值的显著改变。
- Harris方法:偏移量带来的改变由下式表示
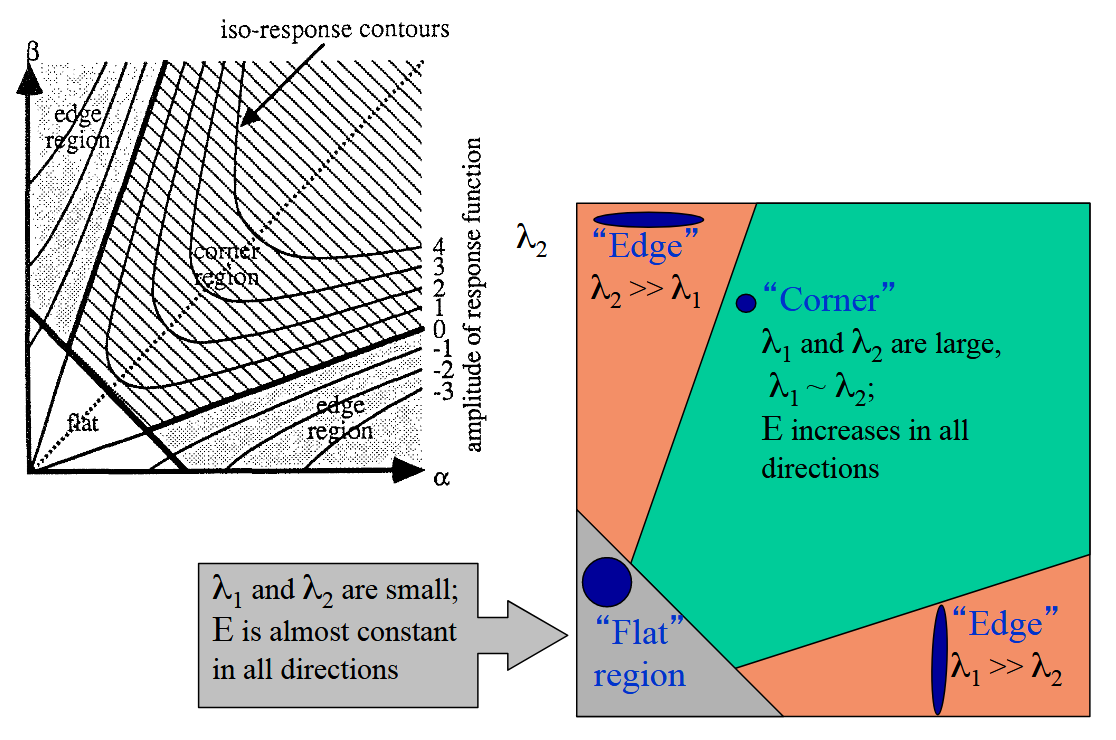
- 理论: $w(x,y)$窗口函数使用高斯函数来平滑图像。Taylor展开得到 令$M=\sum\nolimits_{x,y}w(x,y)\begin{bmatrix}I_x^2 &I_xI_y \\ I_yI_x &I_y^2\end{bmatrix}$,称为结构张量,它的两个特征值指示了两个方向的灰度变化情况,一个较大说明有边,两个都大说明有角点。
- 算法
- 性质:
- 不变性:光照变化时角点位置不变
- 共变性:几何变换前后同一角点仍能被检测到
- 对变化的尺度和剪切变换则不具有上述性质,原来的角点放大后可能是边
- 理论: $w(x,y)$窗口函数使用高斯函数来平滑图像。Taylor展开得到 令$M=\sum\nolimits_{x,y}w(x,y)\begin{bmatrix}I_x^2 &I_xI_y \\ I_yI_x &I_y^2\end{bmatrix}$,称为结构张量,它的两个特征值指示了两个方向的灰度变化情况,一个较大说明有边,两个都大说明有角点。
- 尺度不变检测:
- 解决在尺度不同的两张图中分别找到合适的窗口大小:自动尺度选择算法,即为同一像素点定义不同大小的窗口,并通过响应函数f计算响应值,响应的极值点认为是最合适的窗口,由此可以将两张图片的尺寸归一化。
- 定义响应函数f,使之作用在不同窗口大小能获得相同的值,此外还需要有稳定且容易找到的极值点。通常是求不同$\sigma$的金字塔特征图。
- LoG:改变$\sigma$,乘一个$\sigma^2$来归一化尺寸,求局部特征值。
- SIFT(DoG):求$k\sigma$与$(k+1)\sigma$标准差下的高斯模糊差,不求导数,是对LoG的近似。
- Harris-Laplace:在不同尺度上计算Harris角点,再用LoG方法求响应。
- 仿射不变检测:
- 检测器再仿射变形前后的响应具有一致性
- 最大稳定极值区域(MSER):在所有的灰度值上设定阈值生成二值图像,当阈值改变时,监测每个连通域的面积,那些面积改变的最小的连通域定义为MSER。
- Harris方法:偏移量带来的改变由下式表示
- 局部特征的主要部分:
描述
局部特征描述向量:以兴趣点为中心的图像块。
- 最简单方法:将块内像素排列起来,形成向量。缺点是对小的平移和旋转敏感。
- Scale Invariant Feature Transform(SIFT)描述子:对一个小块,根据梯度方向将像素放到相应的向量维度上,生成梯度方向与数量直方图。多个直方图的方形集合即描述子。4 4共16个子块,8个梯度方向区间,即8 16共128维向量。
- 旋转不变性:以图像块梯度的主导方向为基准进行旋转,从而将块特征对齐到规范方向。
- SIFT方向估计与归一化:选择主导方向并旋转到固定方向,在直方图上体现为横坐标整体移动。
- 光照不变性:
- 在梯度空间计算,故对同一的光照变化量对鲁棒性;
- 向量归一化到0-1,则对乘数有鲁棒性;
- 将大于0.2的向量分量置为0.2并重新归一化,对部分非线性光照变化有鲁棒性。
- 旋转不变性:以图像块梯度的主导方向为基准进行旋转,从而将块特征对齐到规范方向。
- Gradient Location and Orientation Histogram(GLOH)描述子:log极坐标空间中,用径向半径为6、11、15的1、8、8共17个容器,每个容器内像素按照16个梯度方向计算直方图,故得到一个16 * 17共272维向量;再PCA降维到与SIFT相同的128维。
- Histogram of Oriented Histogram(HOG):R-HOG相当于在密集网格中、无需方向对齐的SIFT,C-HOG则径向分容器。对直立人体识别效果较好。
- Shape Context:以某点为中心,计算其他点到该点log-极坐标径向距离的直方图。形状匹配,此外还有$X^2$ distance。检测边缘不可靠时,用高斯函数滤波效果更好。
- 二分图匹配:最小化两个点集的匹配总代价。
- Local Binary Pattern(LBP)二值特征:对每个像素,将邻近的8个像素与它进行比较,值比它大记为1,否则记为0,用8 bit数记录这个像素。在16 * 16网格中计算这种8 bit数的直方图。二值特征还有BRIEF、ORB、BRISK等。
匹配
特征匹配指标:欧氏距离、向量的余弦相似度。同一特征由于在图上可能有重复或者相似较高的其他特征,需要根据指标选择最佳匹配。
- 最近邻匹配:计算特征空间距离,然后
- 去掉高于阈值的点。
- 或者计算最近邻距离与次近邻距离的比值,去掉趋近0的值。
运动特征——光流
- 运动估计方法:
- 基于稀疏特征的方法:点对应,适合图像运动较大的场景
- 密集的像素级运动估计:亮度变化,适合图像运动较小
运动场:
- 运动视差:运动向量距离摄像头越近在图像上的投影越长、
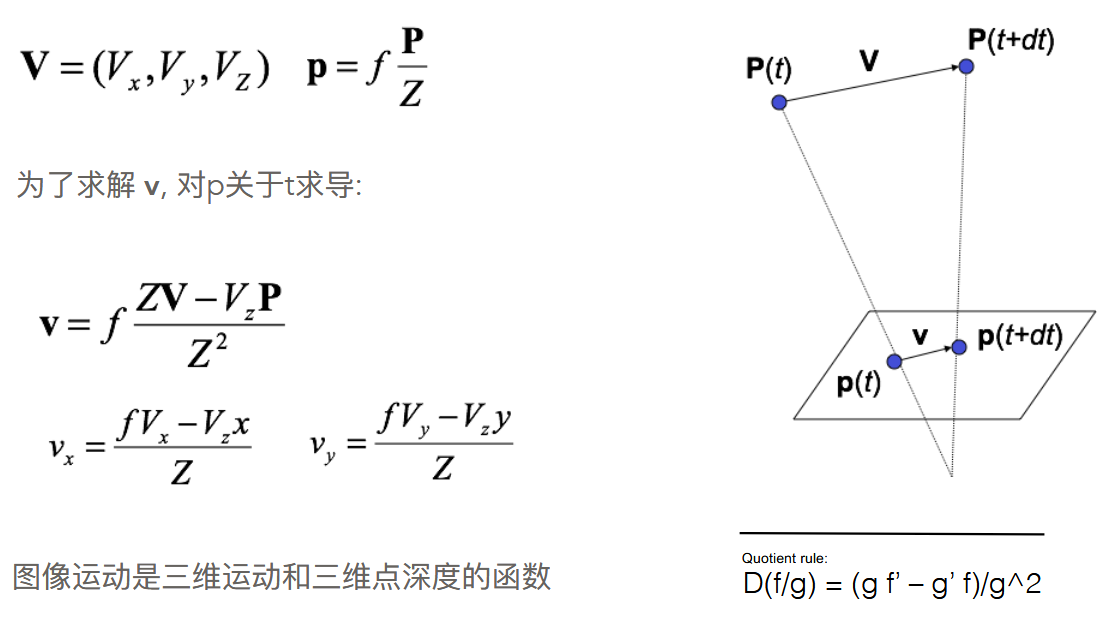
光流:亮度模式的显著运动。此运动可能也是由光照变化造成的。
- 估计假设:
- 亮度恒常:相同点投影在帧间看起来相同
- 微小运动:运动幅度小
- 空间一致:局部邻域内的点运动相近
光圈问题:由于视野狭窄造成的运动方向误判,如理发店的旋转杆。解决方法如下是用一个局部的复数像素避免移动方向上的歧义,Lukas-Kanade算法。
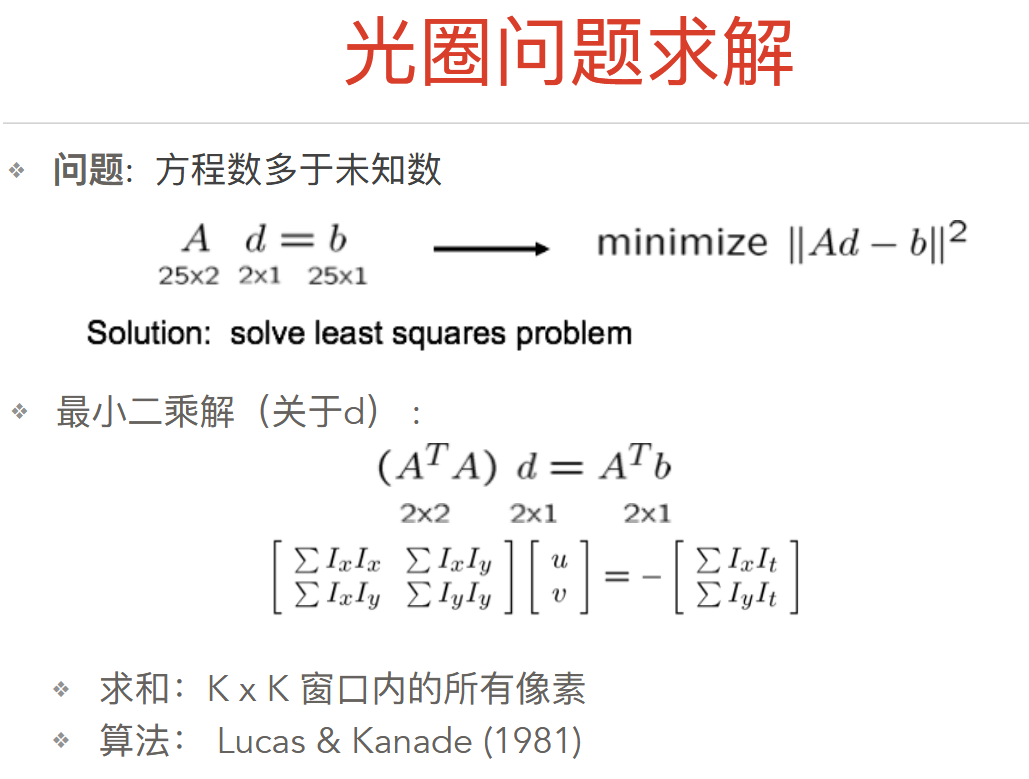
$A^TA$可逆,特征值不是太小,非病态矩阵(特征值之比不是太大)。特征值的特征表现在图上:
- 一大一小:物体边缘。某方向运动很快。
- 都小:纹理稀疏区域。运动很小。
- 都大:纹理密集区域。运动很大。
- 小运动假设不满足时:降低分辨率,Coarse-to-fine分辨率金字塔估计
- 估计假设:
- 运动视差:运动向量距离摄像头越近在图像上的投影越长、
图像视觉表示
- 历史上的图像表示:
- 元像素:所有像素值顺序连接成1维向量。缺点有需要严格对齐,无法处理遮挡,尺度、视角鲁棒性。
- 颜色直方图:优点有对对齐、尺度、旋转等鲁棒性,缺点有空间位置信息缺失。因此有引入分块来克服该局限,不确定分块尺度则可以使用尺度金字塔。
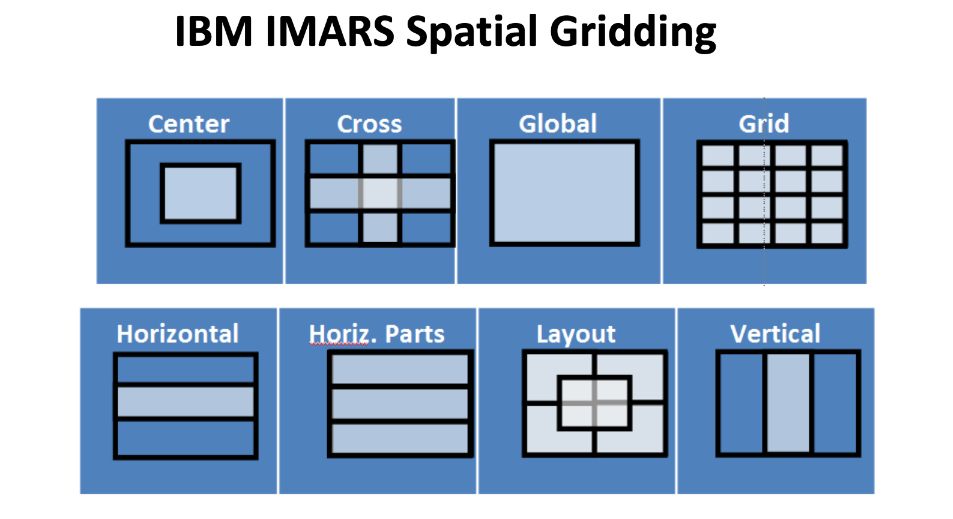
- 梯度直方图
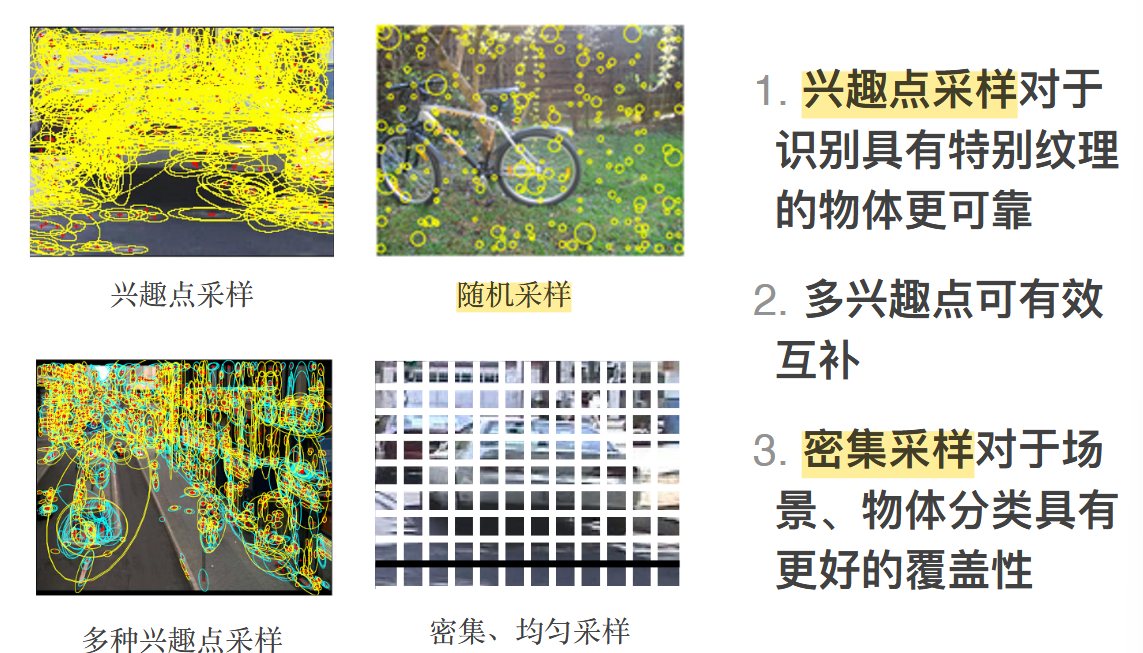
视觉词袋表示(2004):来自文本处理中的词袋模型,关键为统计字典中词汇频率。视觉表示中将纹理元视为词汇。
- 步骤
- 视觉特征采样:原文中使用SIFT
- 学习字典元:支持向量机等
- 特征向量量化到字典元
- 统计字典元直方图
- 视觉特征采样:原文中使用SIFT
- 缺点:空间位置信息缺失,解决同样为尺度金字塔统计。
- 应用:图像索引与检索等
- 步骤
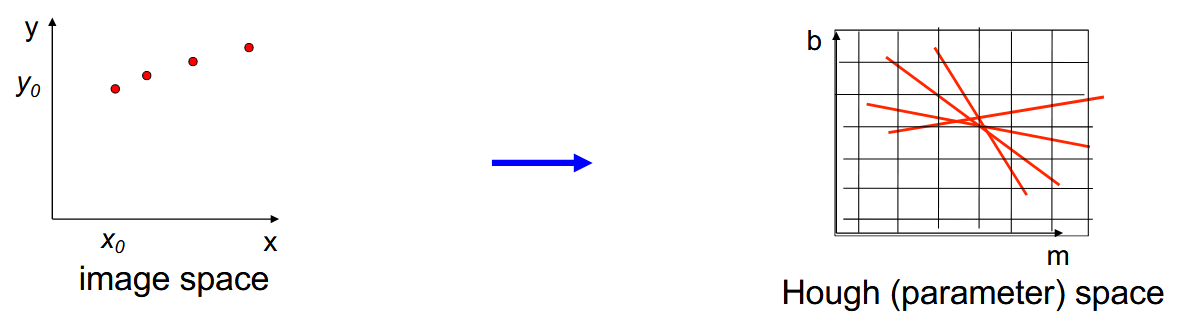
霍夫变换:在霍夫空间中,用一个点来表示一个具体的曲线,如直线、圆等。
- 直线霍夫变换:
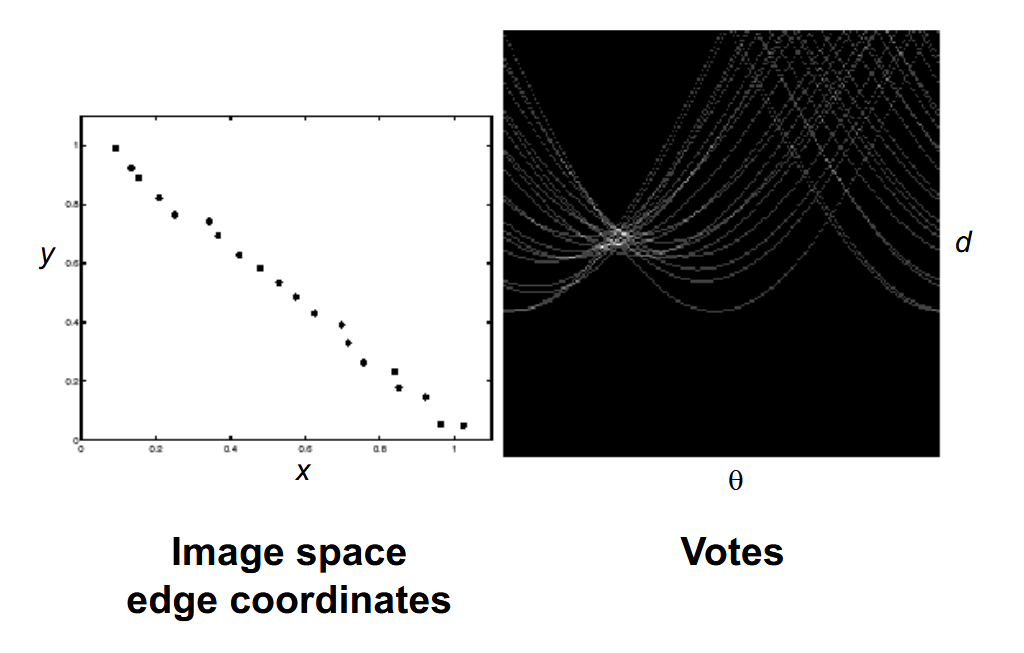
- 如果用$y=mx+b$表示直线,那么已知x-y空间中的一个点就能确认该直线在m-b霍夫空间中的一条直线上;两个点确定该直线;三个及以上点则需要根据$(x,y)$代表的霍夫空间中的直线来给每个可能的组合$(m,b)$进行打分(vote),通常使用二维线性累加器,选出得分最高的$(m_0,b_0)$。
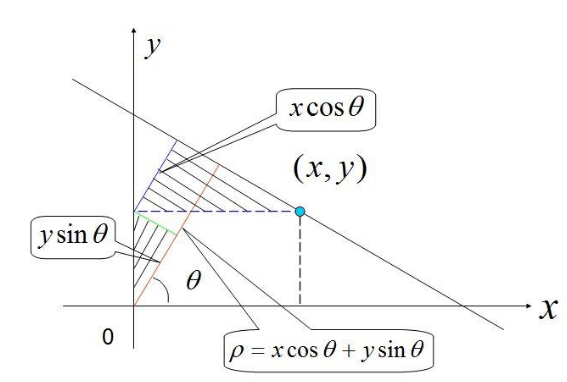
- 习惯上使用极坐标空间,用原点到直线的垂线$(d, \theta)$表示经过某点$(x,y)$的直线,$d=x\cos\theta+y\sin\theta$。
- 如果用$y=mx+b$表示直线,那么已知x-y空间中的一个点就能确认该直线在m-b霍夫空间中的一条直线上;两个点确定该直线;三个及以上点则需要根据$(x,y)$代表的霍夫空间中的直线来给每个可能的组合$(m,b)$进行打分(vote),通常使用二维线性累加器,选出得分最高的$(m_0,b_0)$。
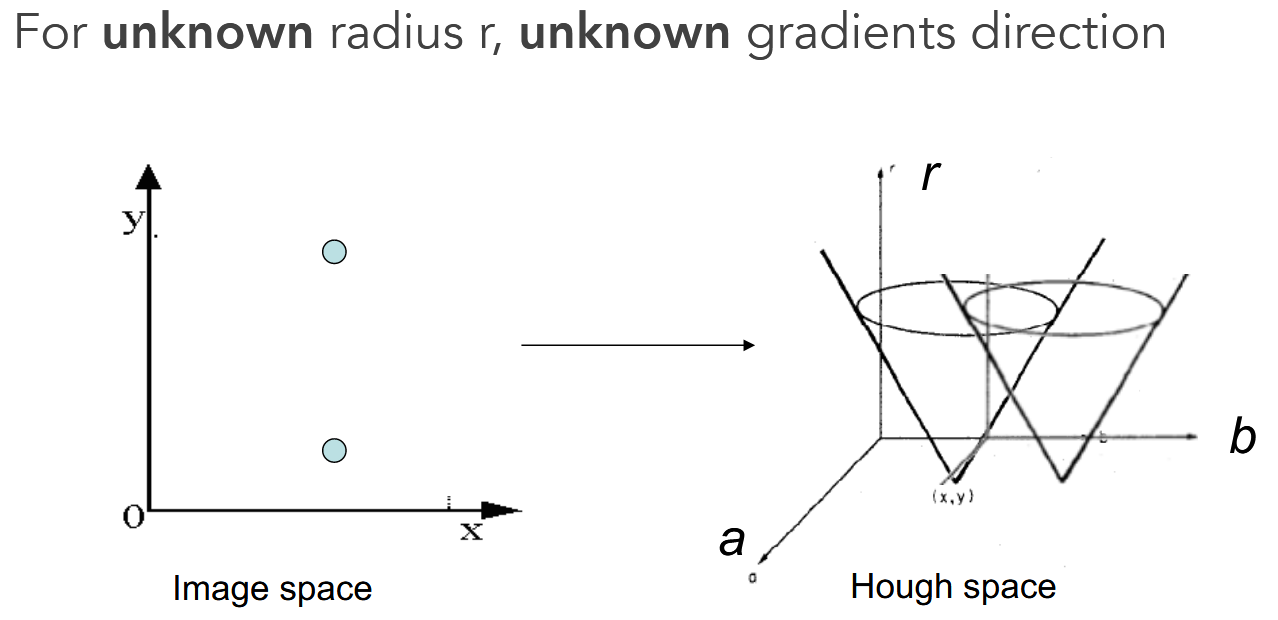
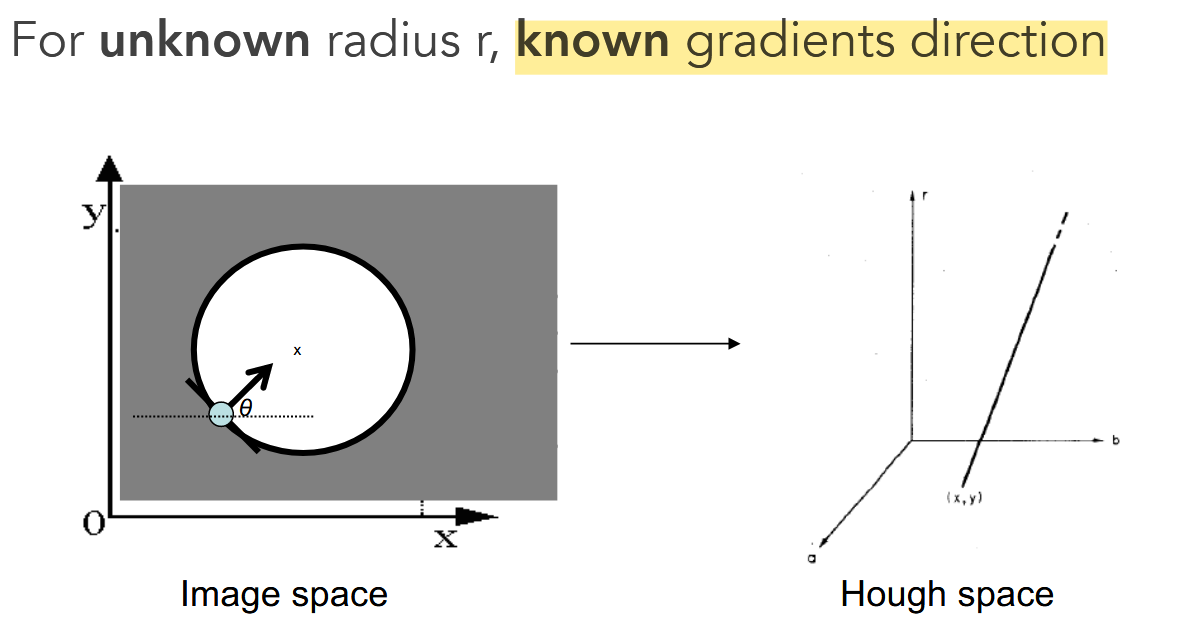
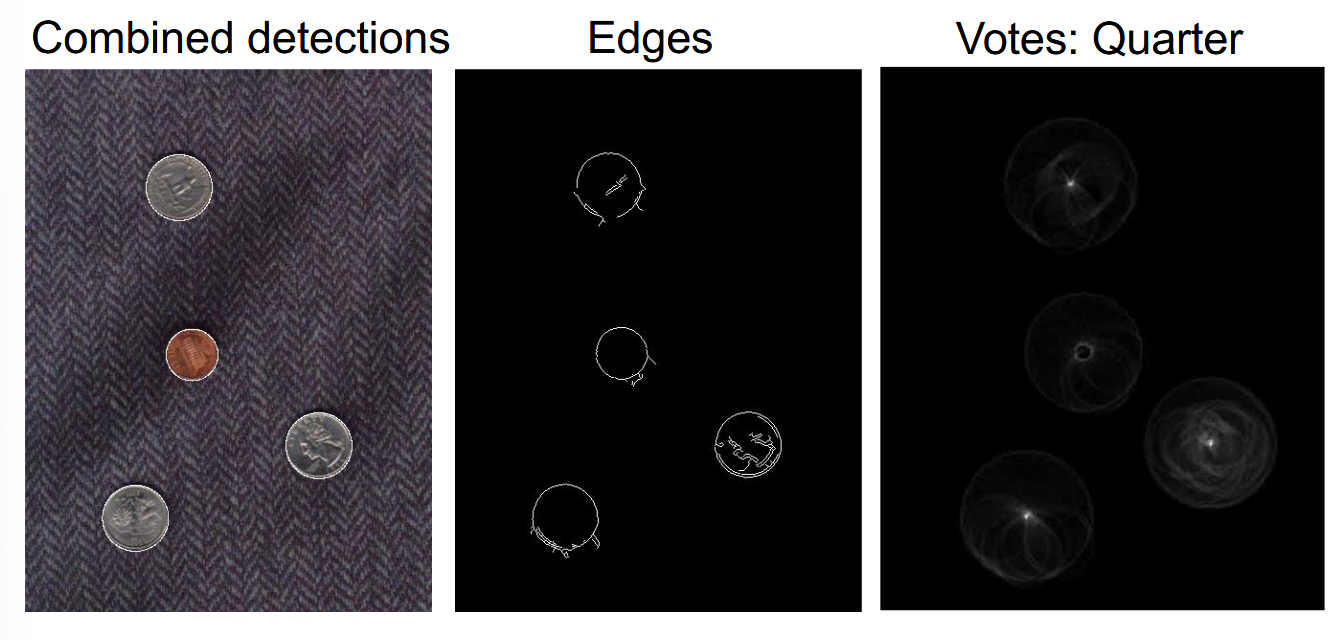
- 圆霍夫变换:根据圆的解析公式$(x-a)^2+(y-b)^2=r^2$,圆的霍夫空间为a-b-r三维参数空间。具体步骤为对每个边缘点$(x,y)$、可能的半径$r$和梯度方向$\theta$,计算$a=x+r\cos(\theta),\;b=y-r\sin(\theta)$,在累加器中向$(a,b,r)$加分,最后取得分最高点。
- 直线霍夫变换:
- 广义霍夫变换:表示任意形状的非解析曲线。
- 步骤:
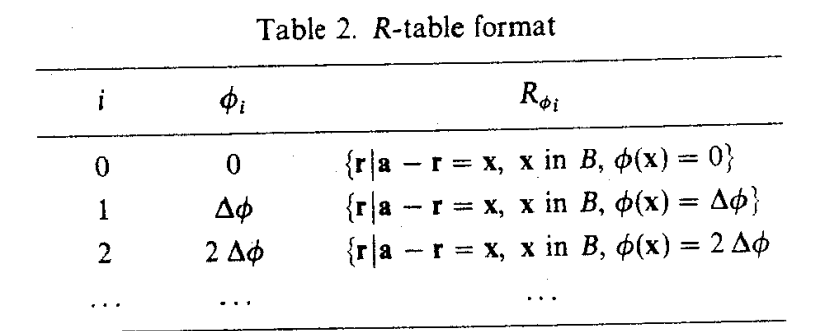
- 对用任意方法得到的边缘点,求R表。R表的计算过程:对曲线内部选定的参考点$a$(通常为中心),遍历每个边缘点$x$以建立一个边缘点梯度方向$\Phi$(垂直切线方向与水平方向的夹角)与边缘点到参考点的平移向量$r=a-x$之映射表。表中每个梯度方向对应的平移向量可能不唯一。
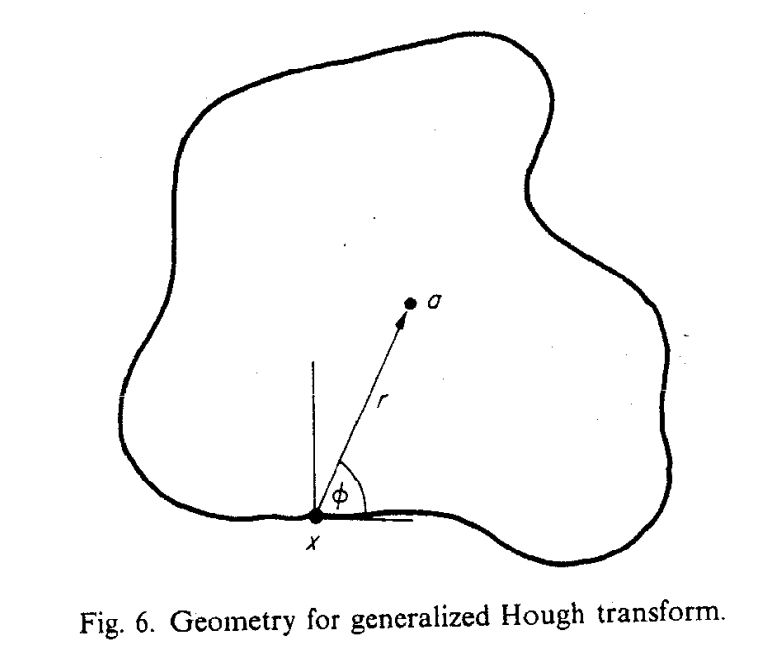
- 对曲线内部所有点,求累积得分(vote):建立一个二维得分表$A(a)$,遍历每个边缘点$x$。以$x_0$和它的梯度方向$\Phi_0$为例,根据R表得到该方向对应的向量$r_{01},r_{02},…$,计算得分点$a_{01}=x_0+r_{01},a_{02}=x_0+r_{02},…$,并为得分点们在得分表中加分。加分可以是常量,可以是关于$x$的函数,也可以是梯度相关的函数等,有不同规则。
- 最后得分最高的参考点就是代表曲线的点。
- 对用任意方法得到的边缘点,求R表。R表的计算过程:对曲线内部选定的参考点$a$(通常为中心),遍历每个边缘点$x$以建立一个边缘点梯度方向$\Phi$(垂直切线方向与水平方向的夹角)与边缘点到参考点的平移向量$r=a-x$之映射表。表中每个梯度方向对应的平移向量可能不唯一。
- 步骤:
图像处理任务
分类与识别
朴素贝叶斯分类器(Naive Bayes Classifier):把物体类别看成满足多种特征的集合,假设特征数量和类别数量有限并且特征之间相互独立(这一点通常不实际),利用条件概率确定类别。具体原理及构造方法见维基百科-朴素贝叶斯概率模型。
支持向量机(SVM):只有两两分类器,多类别分类需要多个SVM来将某类与其他类别分开或者两两分开,最终应用所有SVM给可能的所属类别打分。
两者间的区别同时也是生成模型与判别模型的差异(Generative Model vs Discriminative Model):生成模型是所有变量的全概率模型(建模联合概率),而判别模型是在给定观测变量值前提下目标变量的条件概率模型(建模条件概率)。因此生成模型能够用于模拟(即生成)模型中任意变量的分布情况,而判别模型只能根据观测变量得到目标变量的采样。判别模型不对观测变量的分布建模,因此它不能够表达观测变量与目标变量之间更复杂的关系。因此,生成模型更适用于无监督的任务,如分类和聚类;大部分判别模型本身是监督学习模型,不易扩展用于非监督学习过程。对于诸如分类和回归问题,由于不考虑联合概率分布,采用判别模型可以取得更好的效果。而生成模型在刻画复杂学习任务中的依赖关系方面则较判别模型更加灵活。
It is more important to have more or better labeled data than to use a different supervised learning technique.
❖ K-nearest neighbor ❖ SVM ❖ Naïve Bayes ❖ Bayesian network ❖ Logistic regression ❖ Randomized Forests ❖ Boosted Decision Trees ❖ Restricted Boltzmann Machines ❖ Neural networks ❖ Deep Convolutional Network ❖ …
物体检测
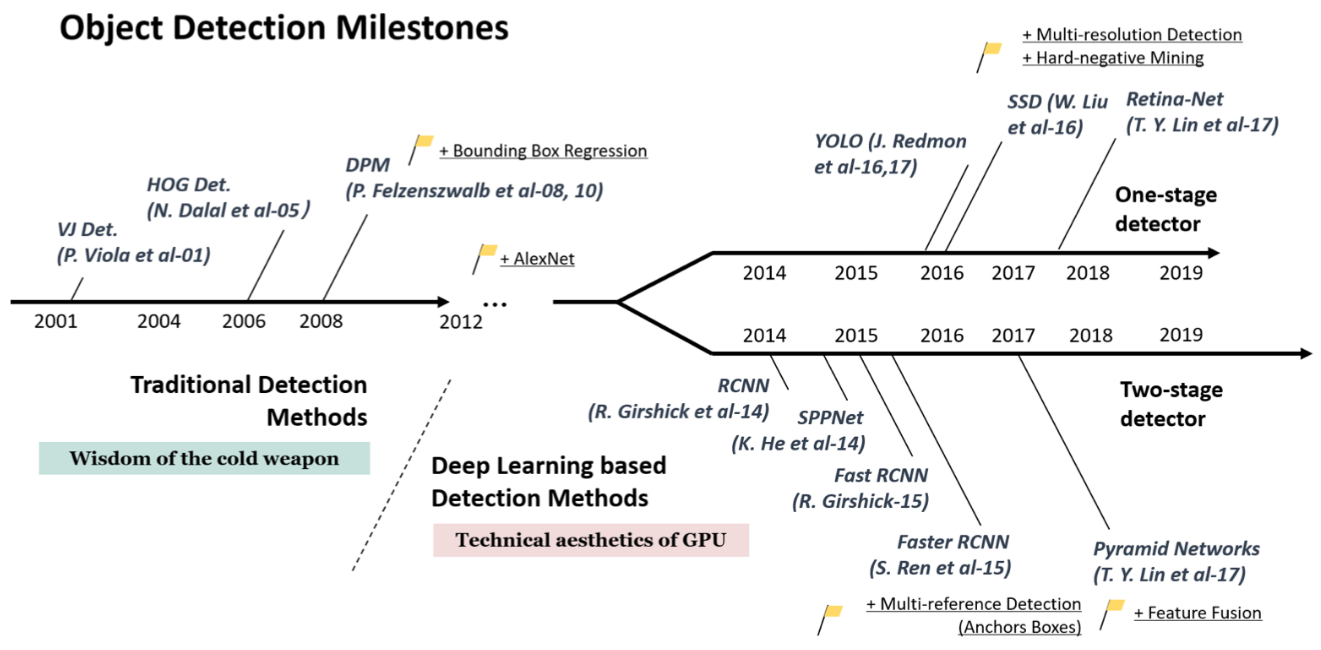
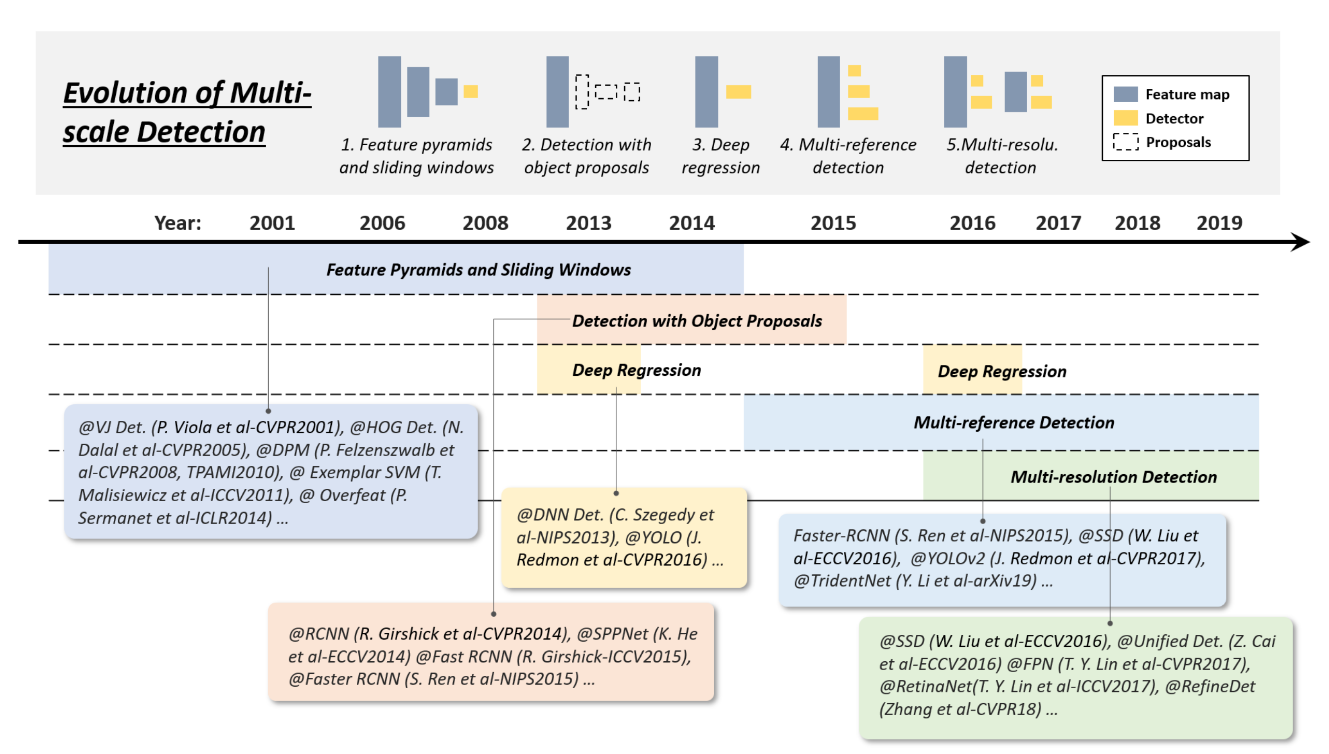
图片来自Object Detection in 20 Years: A Survey
图像分割
目标:将特征分成聚类、获取图片关键部分的紧凑中间表示
自底向上的分片——聚类:只有数据、没有标签的无监督学习,聚类问题的核心矛盾是开始时既不知道各聚类中心也不知道有哪些聚类,为此出现了很多方法:
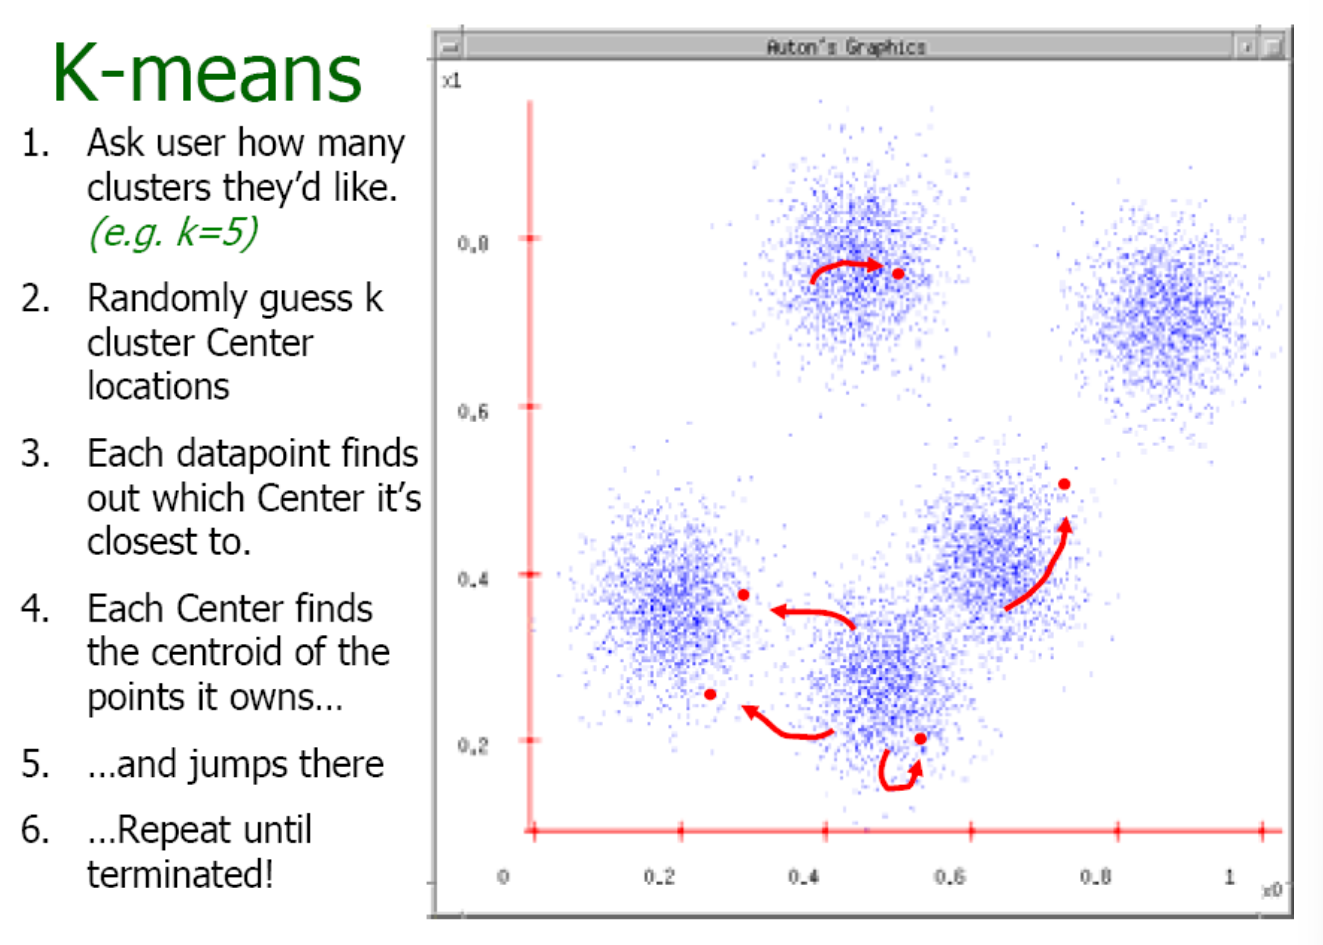
- K-means:随机初始化K个聚类中心。将点加入最近中心的聚类,将每个聚类的中心更新为它的平均位置,重复第二步。问题是容易变为局部最小值,并且没有考虑聚类。
- Expectation Maximization(EM):会估计点属于聚类的概率,K-means的概率变种。
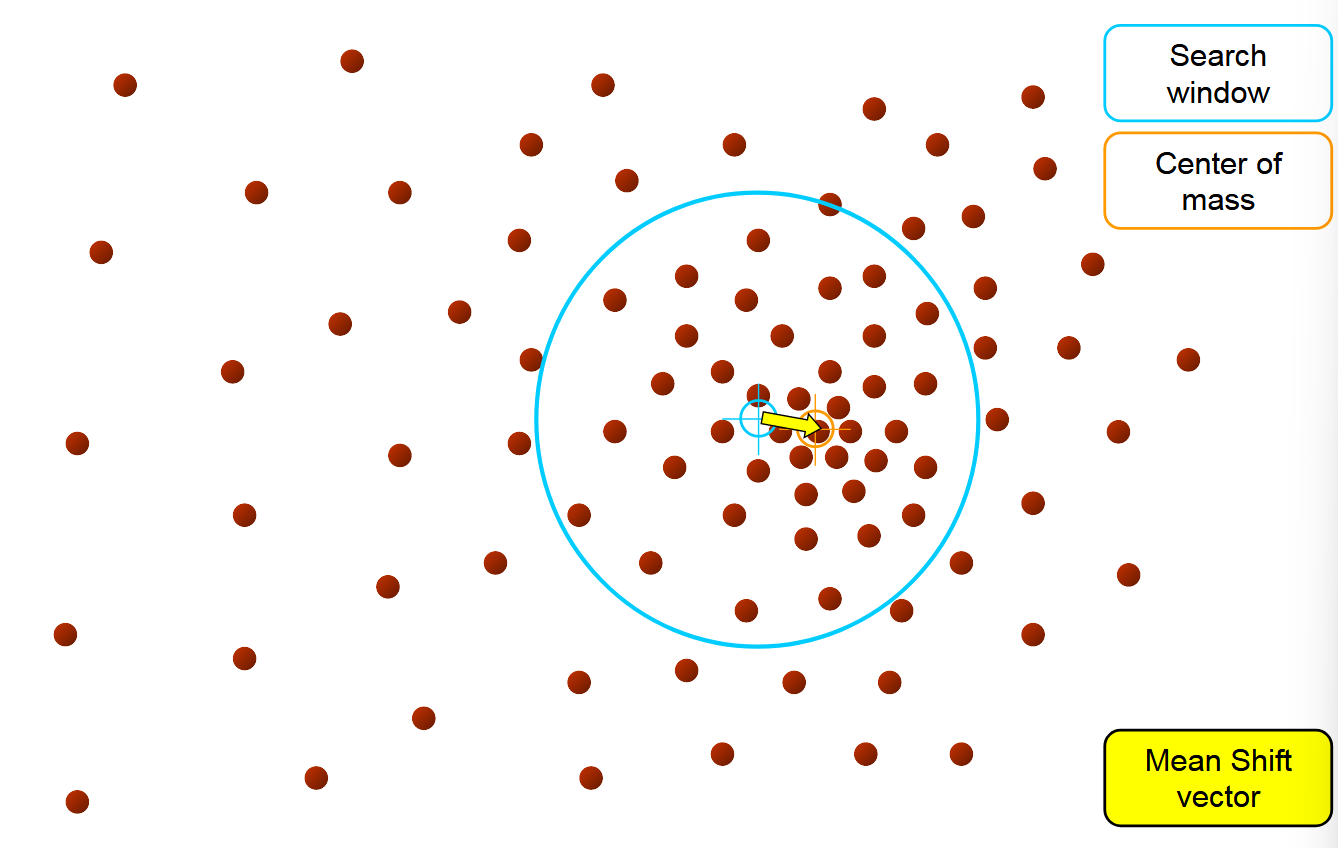
- Mean Shift:在任意中心、一定半径的搜索窗口内,根据窗口内计算得到的特征点质心移动待定的聚类中心,接着以新中心作新的搜索窗口,不断重复。
- Graph Cut: 将所有特征点视为全连接图,用距离或者其他函数度量点间权重,找最小割。Normalized Cut加入以下正则来改善最小割的小块化趋势:$Ncut(A,B)=\frac{cut(A,B)}{assoc(A,V)}+\frac{cut(A,B)}{assoc(B,V)},\; assoc(A,V)=\sum\nolimits_{e\in V}w_e$。缺点是计算复杂度高。
可变轮廓:用可变边界调整目标轮廓,优点是很容易接近高梯度位置、并且可以随物体变化而变化。
- 轮廓表示:一组离散的节点,每次迭代可调整每个节点的位置
- 能量函数:外部能量函数寻找边缘,如梯度, 内部能量函数约束轮廓形状,如弹性与曲率,s为节点序号 总能量函数即两者的比例和$E_{total}=E_{internal}+\gamma E_{external}$,通过$\alpha,\;\beta,\;\gamma$可调整轮廓效果。
- 轮廓调整:可以贪心地让每个节点移动到最佳近邻,也可以动态规划
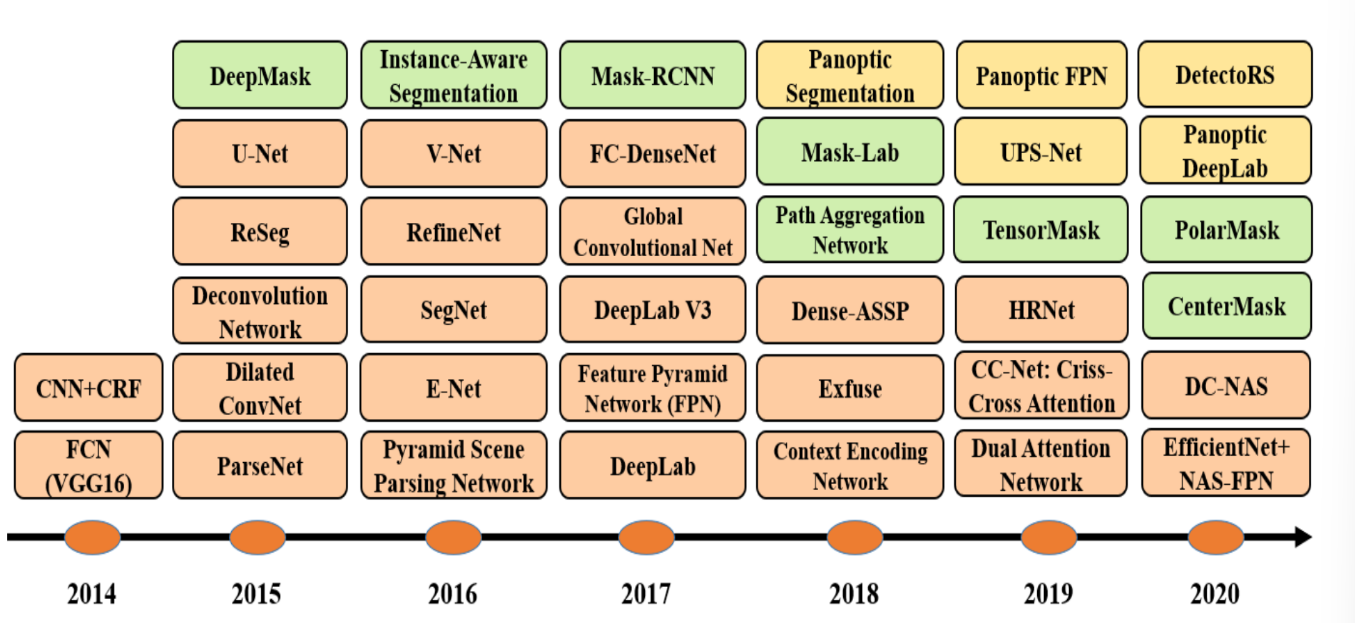
深度学习方法:
- 方法:
- 全卷积网络:卷积网络能提取特征得到热力图、解卷积网络能升采样得到分片图
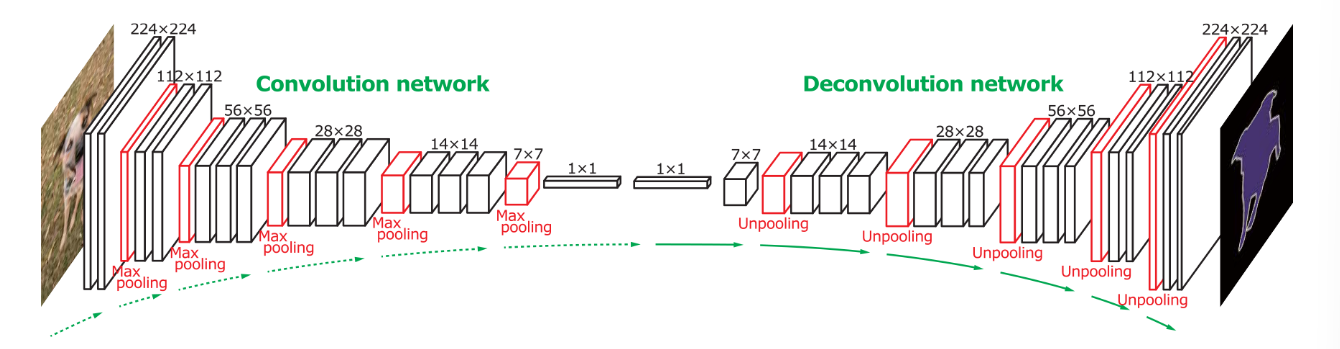
- 带概率图模型的卷积网络,常见的有条件随机场、马尔科夫随机场
- 基于编解码器的模型,如U-Net
- 多尺度金字塔网络模型
- 循环卷积网络模型
- Transformer、GAN ……
- 全卷积网络:卷积网络能提取特征得到热力图、解卷积网络能升采样得到分片图
- 数据集:常用的二维数据集有PASCAL VOC、MS COCO等,2.5D数据集有Stanford 2D-3D等。
- 评价指标:如像素精度、平均像素精度、交并集商等。
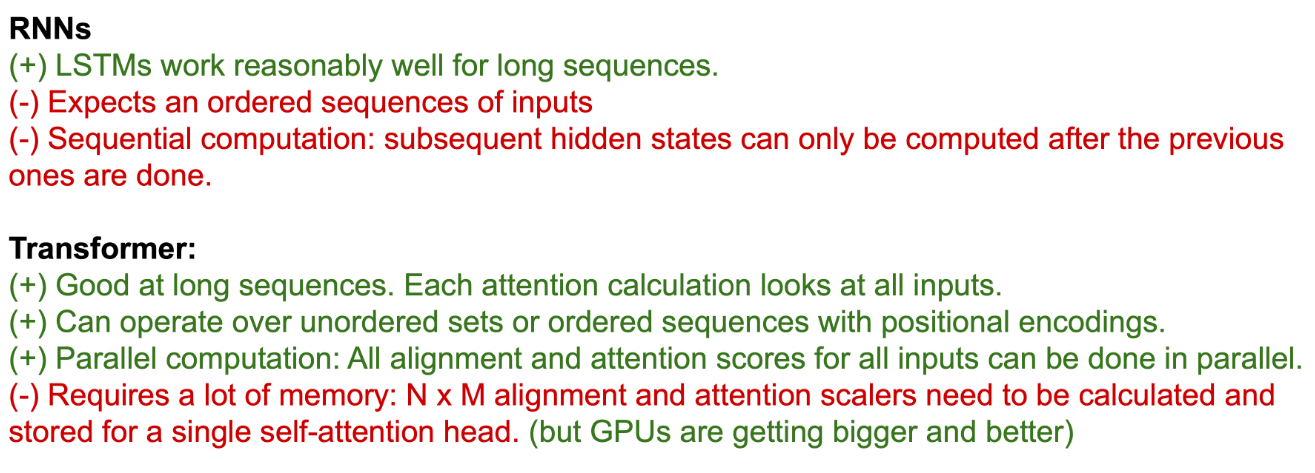
Transformer与RNN的比较
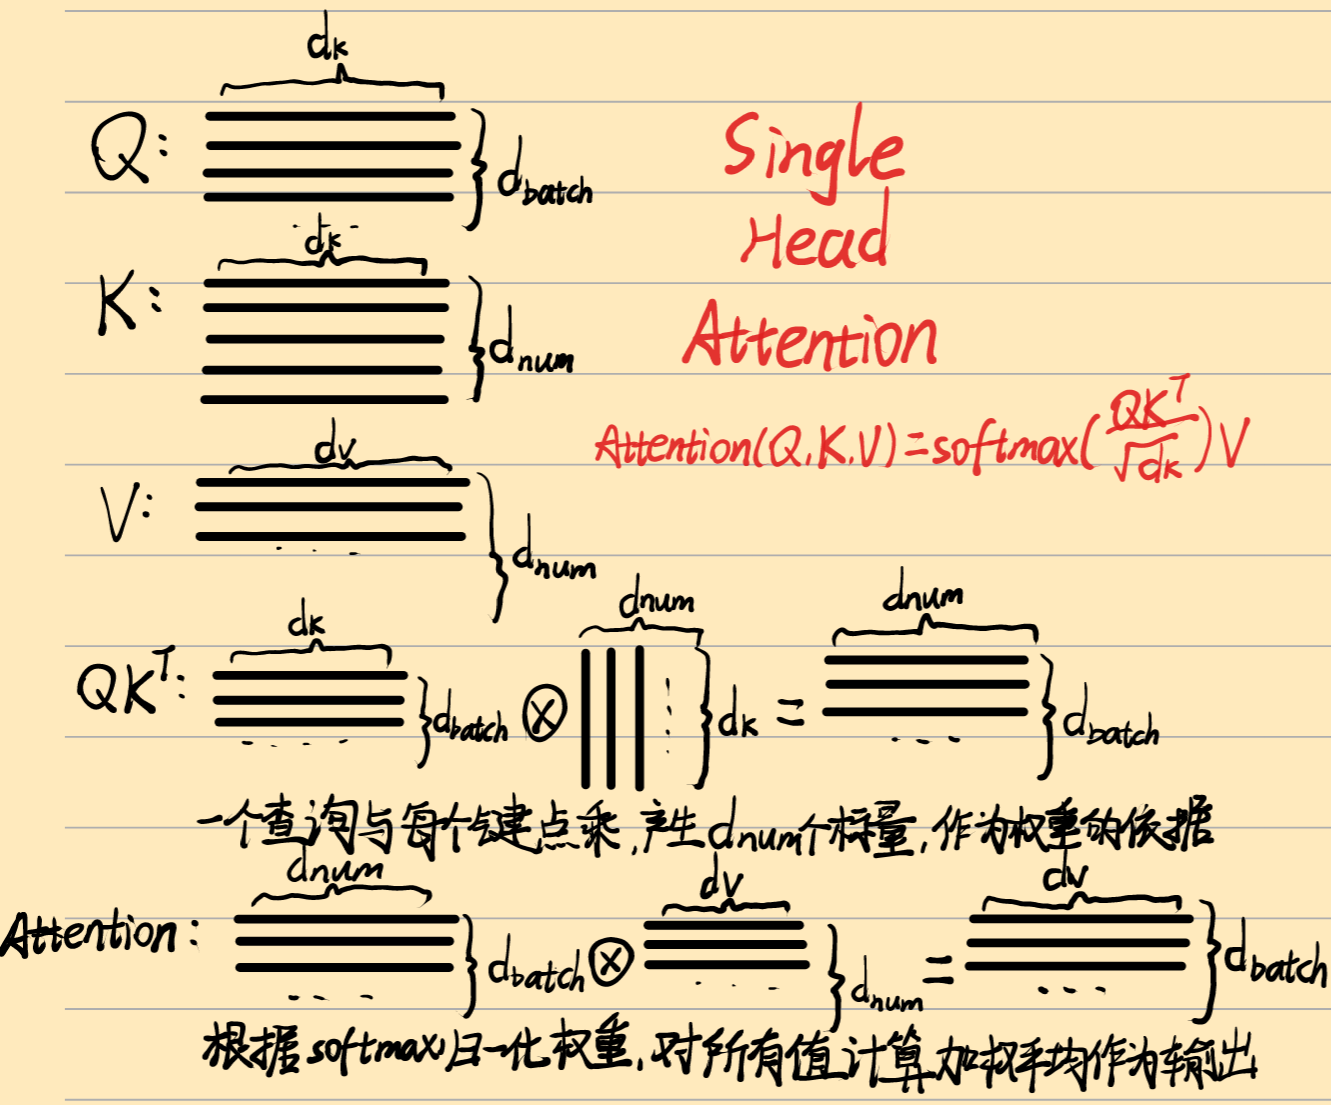
Single Head Attention的计算细节
补充
- Cost Volume:随着深度学习而兴起的概念,是指在有多视角输入时,将原图或者特征图与相邻视角逐像素、逐视差(disparity)地计算相似度。相似度的计算方法有一定灵活性,常见方法有L2误差、前后特征耦合以及互相关系数(如ZNCC))等
- 在RGB图片情况下,维度为$D \times H \times W$,即 视差 x 高 x 宽。在传统多视角立体匹配问题中,可以将视差替换为深度,衡量不同深度的代价从而估计深度
- 在批量多通道特征图情况下,维度为$B \times C \times D \times H \times W$,即 批量 x 通道 x 视差 x 高 x 宽。通常会作为NN的输入
猫才毛
Live for what I love ~