Time Complexity
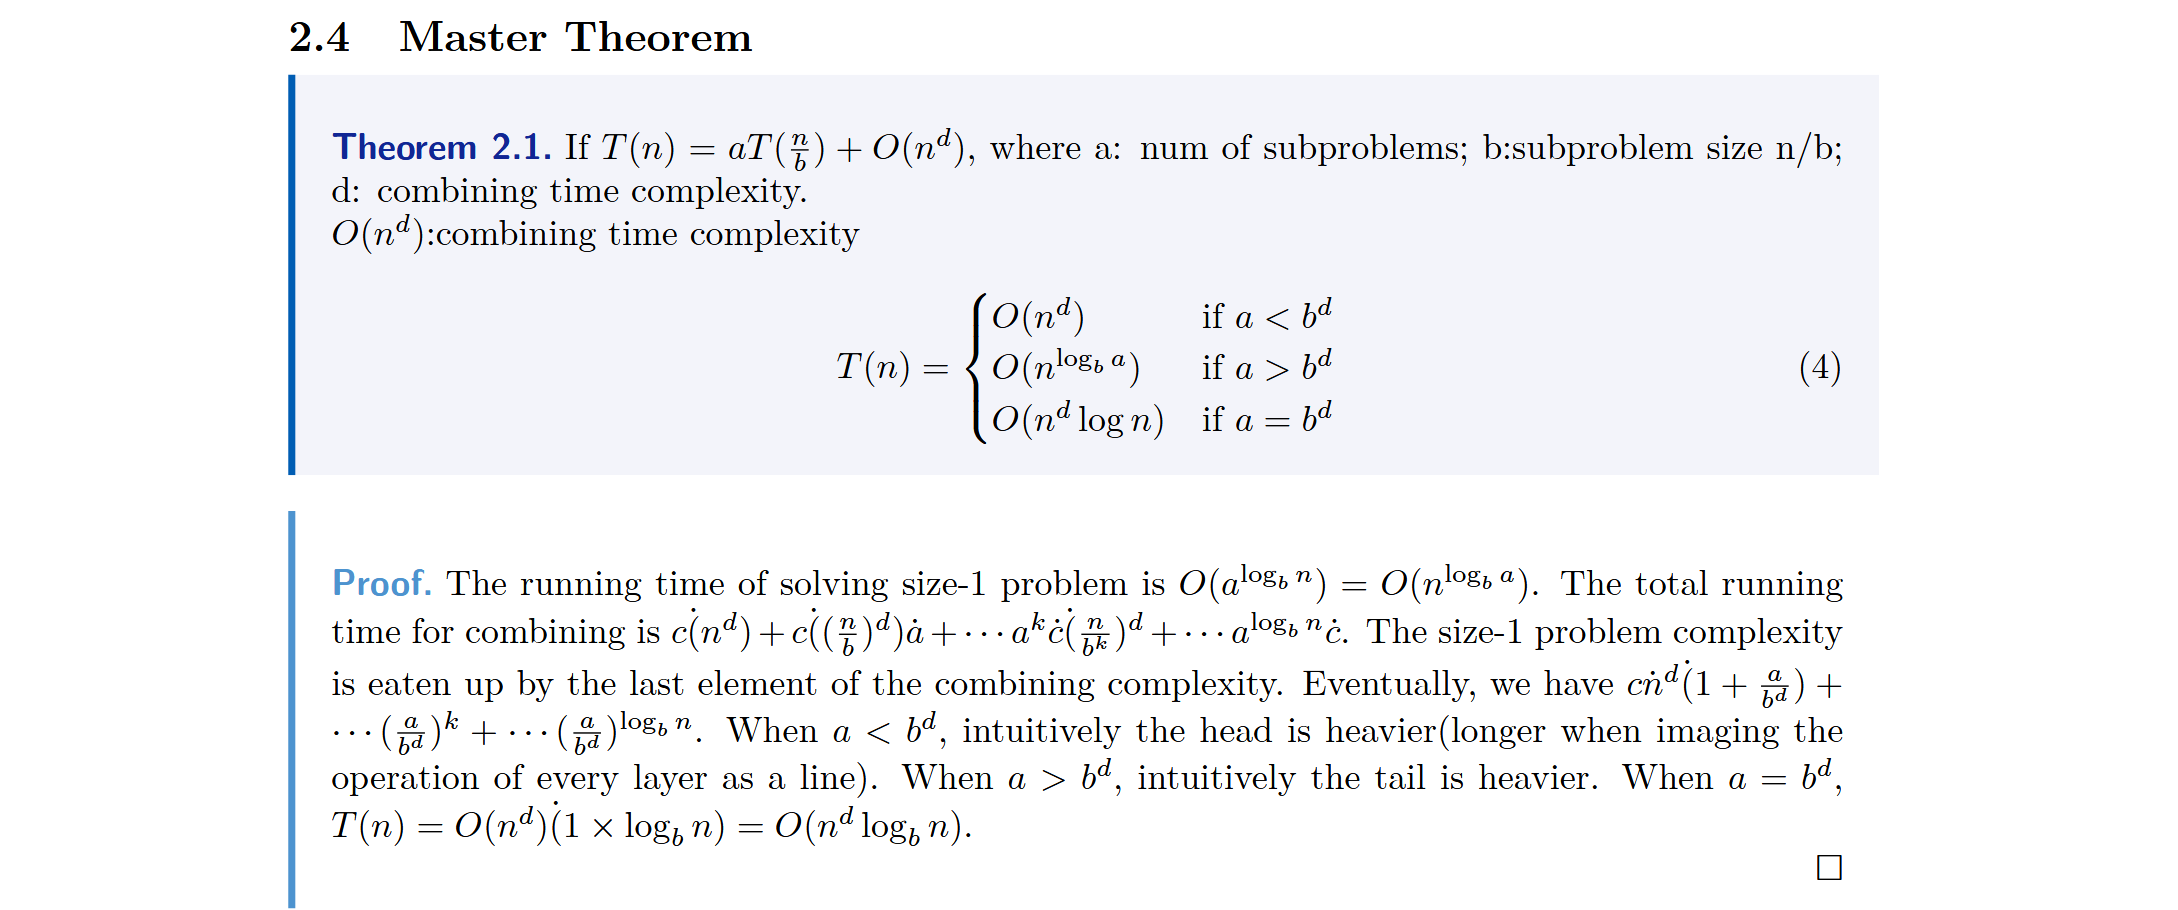
Divide and Conquer
- Count Inversions : 把数组分成前后两部分A,B,直接考虑A与B间交叉的逆序对,可以通过将排序后的A、B按序合并来计数,即$i
- k-th smallest : 使用快排分成三组(M=pivot, R>pivot, L<pivot)
- 找一个好的pivot : 把所有数五五分组($O(n)$),每组找到一个中位数($5!=O(1)$),取所有中位数的中位数($T(n/5)$),该数一定至少大于$n/10$个中位数+小于这些中位数的$2n/10$个数,小于$3n/10$个数,达到了比较平均地分开LMR的目的。
- 快排结束中,将k与$|L|,|L|+|M|$比较,决定k-th smallest是在L、M、R哪一组中。
- Closest pair :
- divide : 把所有点根据x坐标排序($O(n\log n)$),把空间按x坐标分成左右两部分A、B,分别找A、B内最近对,接着只要解决A、B间最近对。
- combine : 假设A、B内最小距离为$\delta$,只要关心分割线左右两边$\delta$区域,对于该区域内每个点先根据y坐标排序($O(n\log n)$),只用考虑它上方$2\delta \times 2\delta$区域内的其他点,可以证明该区域内最多只有其他7个点。$T(n)=2T(n/2)+O(n\log n)$,$O(n\log^2 n)$.
Graph
- DFS : 算法是遍历所有未访问的节点、根据节点的出边递归访问其他未访问节点。可以用作生成树的方法。
- Cycle Existence : 生成树之外存在back edge即存在环。
- Topological Ordering (DAG) : DFS的同时记录开始访问该节点和结束访问的时间,结束的时间的从大到小排序即合理的拓扑序。或者每结束一个访问就将该节点加入序列中,最后逆序输出,时间复杂度$O(|V|+|E|)$。
- SCC : 由于DFS最后一个结束访问的节点一定在头SCC中(要么有通向其他SCC的边要么单独为SCC),
- Lemma 1:在反向图$G^R$中DFS的最后结束访问节点则一定是$G$中的尾SCC(没有通向其他SCC的边)。
- Lemma 2:按DFS结束时间从大到小顺序访问节点一定在当前$G$中去掉已访问节点的尾SCC。
- Algorithm : DFS $G^R$,按结束时间从大到小顺序在$G$中DFS这些节点,每次访问到未递归访问的节点即一个SCC。时间复杂度$O(|V|+|E|)$
- BFS : 算法是将按bfs序访问到的节点分层,即每访问到一个节点,将它的后继未访问节点加入下一层,该层访问完毕后开始访问下一层的节点。
- Shortest Path without Weight : 距离即BFS层数,路径可用pre数组记录前驱节点。
- Shortest Path with Positive Weight (Minimal Spanning Tree): Dijkstra,$|V|$轮每次加入树的节点是离起点最近的,然后更新该节点通往的其他节点的距离,可以用最小堆来维护。时间复杂度不用堆为$O(|V|^2(找|V|次最近点)+|E|(遍历所有边)$,用Fibonacci堆为$O(|E|+|V|\log |V|)$,均摊分析Fibonacci摘顶为$O(\log n)$其他为$O(1)$。
- Shortest Path with Negative Weight : Bellman-Ford,遍历所有边$|V|$轮,如果没有负边,生成树在$|V|-1$就结束了;否则,会有生成树内的节点在第$|V|$轮被重复更新。时间复杂度为$O(|V||E|)$。
Greedy
证明思路 : 空集开始,假设第k步为OPT,证明第k+1步贪心后仍为OPT。
- Minimum Spanning Tree :
- Prim’s Algorithm : 维护每个节点到生成树的最小代价$cost$,贪心地每次取离生成树代价最小的新节点。使用Fibonacci堆的时间复杂度$O(|E|(每条边都被检查是否更新cost)+|V|\log |V|(摘|V|-1次小顶))$。
- Kruskal’s Algorithm :
- 按权重从大到小在不成环的条件下加入边,时间复杂度至少为$O(|E|\log |E|(排序))$。
- 判断是否成环,需要$Union-Find Set$转换为判断加入的边的两端点是否在同一组内。时间复杂度为$O(|E|\log |V|(|E|次判断成环))$。
- Union-Find Set with Path Compression : $Find$操作的均摊分析
- 与根相连的边charge to the find operation;
- Separate vertices by rank into $\log \log |V|$ groups (Lemma : rank为k的树至少有$2^k$个节点), group $i$ is rank$[k_i + 1, 2^{k_i}]$. 对一次$Find$操作来说跨组charge不超过$\log \log |V|$次,对一个节点同组charge不超过$|V|/2^{rank}$(Lemma : $[k+1, 2^k]$组至多有$|V|/2^{k}$个节点)。
- Huffman Encoding :
- Sort + Heap : $O(n\log n)$
- Sorted + two queue (一个存放原节点,另一个存放合成节点,在两个队列中比较并取最小的两个节点) : $O(n)$因为合成节点的个数不会超过n。
- Approximately Optimal : 证明算法$ALG \leq \alpha OPT$。
- 资源分配问题考虑最后一个分配的事件$p_n$,为证$ALG=t+p_n \leq \alpha OPT$通常需要证明$p_n \leq (alpha-1)OPT$。可以先假设大于,然后使用反证法。
Dynamic Programming(Overlapping subproblems optimization)
算法思路:设计一个递归算法(找到子问题),合并(如存储等)相同的子问题,如果问题图是一个DAG则可以使用拓扑序完成它。关键点是找到下一个状态的转化公式。
证明思路:归纳分析,合理的拓扑序提供了一个合理的归纳顺序。
- Longest Increasing Subsequence:可以看成从一个连接所有节点的新节点开始到当前节点的最长路径,$i<j,a_i<a_j$时两个节点间有边。存储到每个节点的LIS,拓扑序就是从1到n。时间复杂度$O(n^2)$。
- Edit Distance:转化为寻找最佳对齐方式,对于长度分别为m、n的字符串x和y,当$Best[i-1,j-1],Best[i,j-1],Best[i-1,j]$已经确定时,所以可以记录一张长宽分别为m、n的Best表格,之字形求解其中每个元素。时间复杂度$O(mn)$。
- Knapsack Problem:有限预算买物品,希望最大收益。注意由于$W$作为数量,可能为输入bit数的指数,时间复杂度可能非多项式。
- Baseline:使用$f[i,w]$记录考虑前$i$种物品(第i种可买可不买)和使用$w$预算的最大收益,更新规则如下,时间复杂度为$O(nW)$(物品种数和最大预算)。
- With Surplus Supply:思路相似,记录考虑前$i$种物品(是否将第$i$纳入考虑,可以重复买)和使用$w$预算的最大收益,时间复杂度为$O(nW)$。 不过实际上只需要记录$f[w]$,即根据当前钱数,一个一个考虑物品。
- Priority Queue:
- Maximum in k-long sliding window:维护优先队列,摘大顶即可。优先队列:1. 用heap的时间复杂度为$O(n\log n)$;2. 一个总长不超过k的优先队列(所谓Potential Queue),其中被滑出窗口和小于后来者的被删除,后来者直接加入。时间复杂度为$O(n)$。
- Longest Increasing Subsequence:维护每个长度下的Potential Sheet $sm[i,len]$(前i个元素和递增长度为len),其中第i个元素可以用二分法找到可能更新的长度位置,要么比已存在的表格元素小故更新,要么增加长度。结果即$sm$表中最长的,时间复杂度$O(n\log n)$。
- Graphs:
- Shortest Path Bellman-Ford:维护$dist[k,v]$表格(从出发点$s$到节点$v$不超过$k$条边的最小权重)。
- All Pair Shortest Path Floyd-Warshall:维护$dist[k,u,v]$表格(从u出发到v的仅考虑${v_1,…,v_k}$k个点的最短距离),更新规则如下,实际上也可以一直更新$dist[u,v]$表格。时间复杂度为$O(|V|^3)$。
- Traveling Salesman Problem:维护$f[S,v]$($S$为所用节点集合,可以用0和1串的十进制表示,$v$表示终点的最短路),更新规则如下,最终结果为$f[V,v]$,时间复杂度为$O(|V|^2 2^{|V|})$。
- Maximize Independent Set on Trees:独立集是相互间没有边的节点集合。维护$f[v]$(以$v$为根的子树的最大集),更新规则如下。时间复杂度为$O(n)$。 也可以贪心地使用DFS,总是选择更靠近叶子的节点,丢弃其父节点。拓扑序可以用二叉树的中序遍历。
- Channel Coding:
- Viterbi Algorithm in the Trellis Diagram:Trellis Diagram作为卷积码编码方式的一种,存有每种寄存器状态在不同序列索引下的转换路径。Viterbi算法用于找到最佳解码路径,按编码索引顺序累积每一条路径的代价(路径输出码与接收码的汉明距离),在路径交汇处丢弃累积代价较大的路径,于是在每一索引为每个状态保留了一条最优路径,直到索引结束输出累积代价最小的路径输出码作为预测码。等价于有向无环图的Dijkstra算法。
Network Flow
- Flow Cancellation:找到一条s-t路反向经过有向边时,认为是撤销了这条边上的部分流量。
- Residual Network:$G\rightarrow G^f \; about \; f$。在原图的基础上,保留每条边的正向流量作为边权值,同时构造反向边,权值为容量-流量。
Maximum Flow Problem:Ford-Fulkerson Algorithm,每次都在残差图上找一条s-t路径,并以路上的最小边权重更新残差图,直到再也找不到s-t路为止。
- 边缘情况:图中某两个点间原本就有正反向边,可以加一个点把两条边变成三条边以去除双向。
- 收敛性:整数情况下每次至少增加1,会收敛;无理数情况下不一定停止,并且也不一定收敛到正确结果。
- 正确性:Max-Flow-Min-Cut Theorem
- 时间复杂度:$O(|E|\cdot f_{max})$
应用:关键是构造可以使用最大流相关算法的图
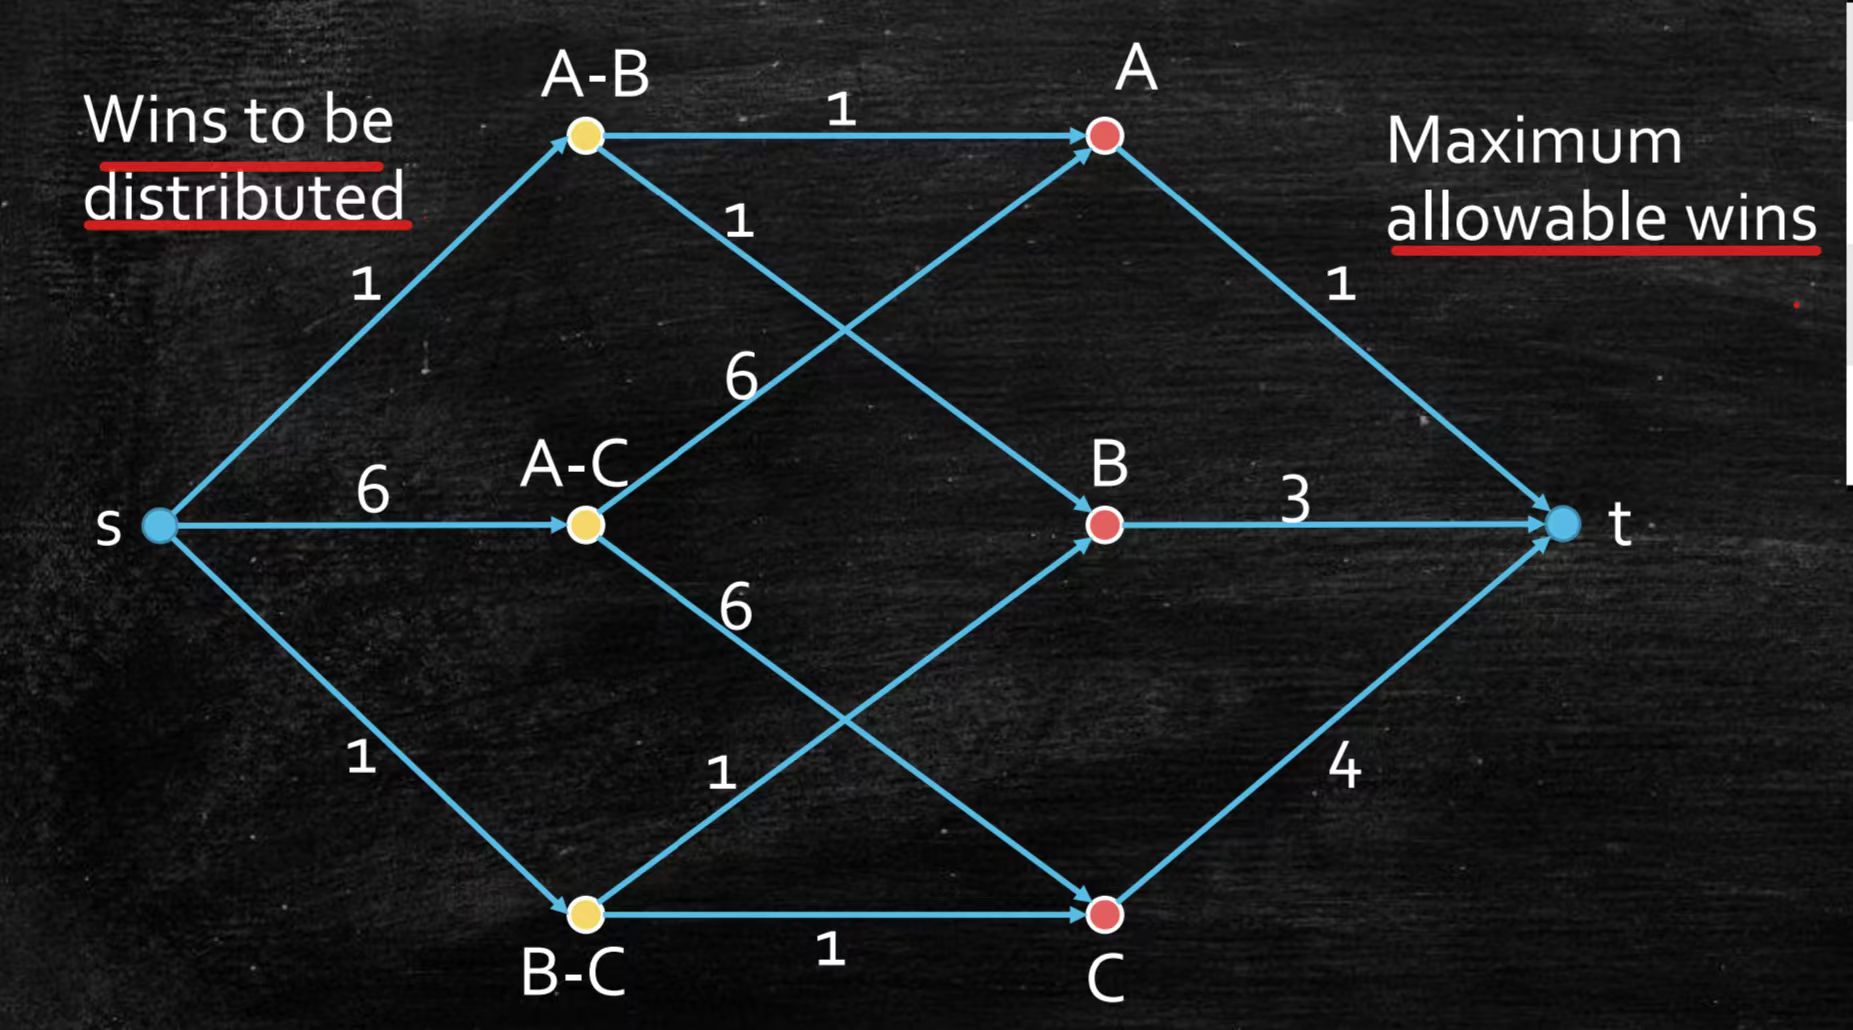
比赛预测:构造起终点s和t。为让D赢,ABC各有可以赢的最大场数,将这些场数作为它们连接终点t的边权值;再构造A-B\A-C\B-C三个点,以各队间比赛场次与起点s连接,再分别与各自的两队连接。
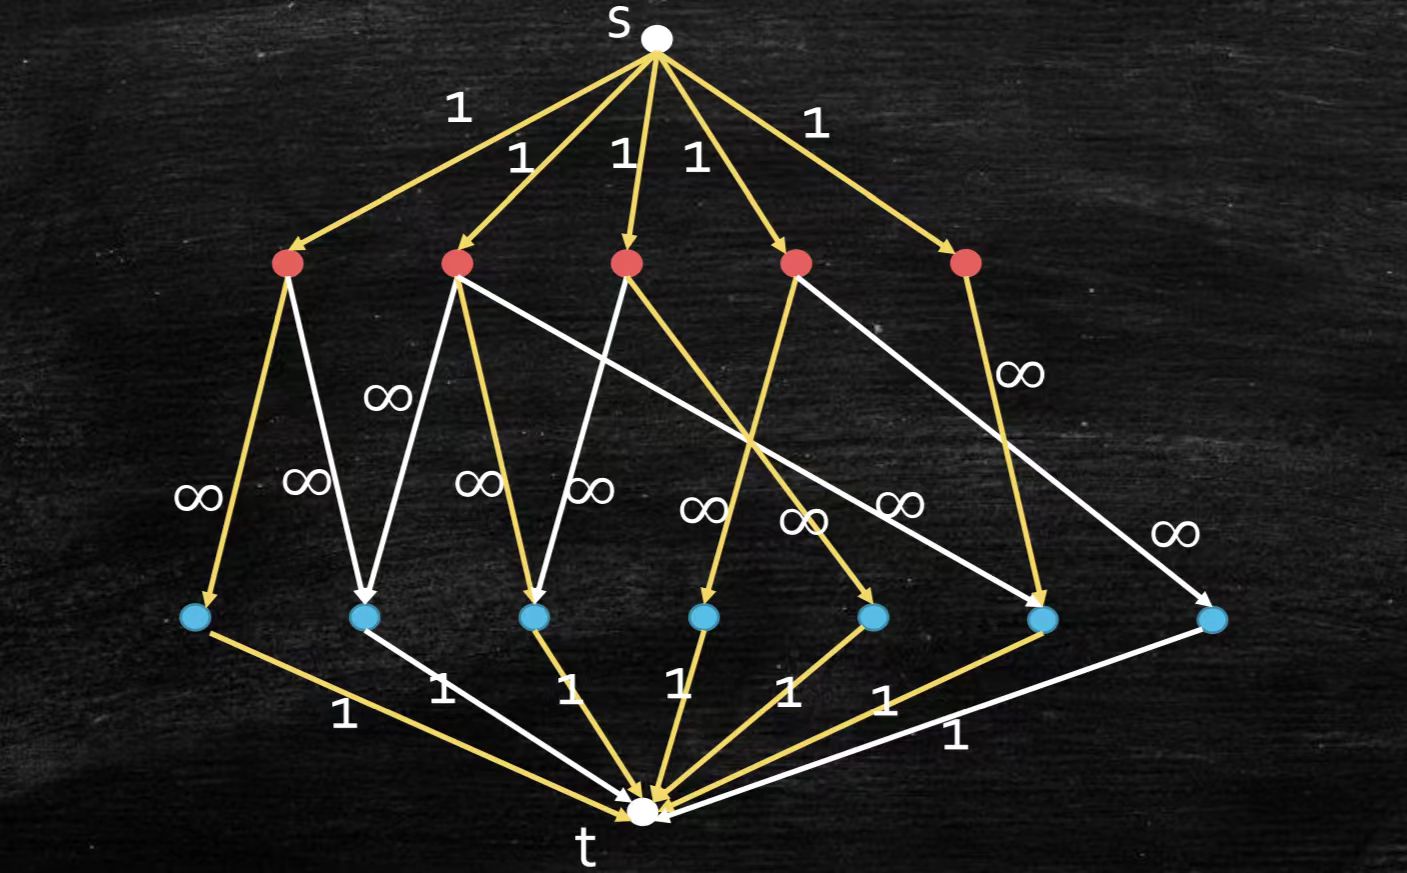
Maximum Bipartite Matching:构造起终点s和t。s连接匹配一方的所有点,边权值为1;t连接另一方;双方边权值可以无穷大。
Max-Flow-Min-Cut Theorem:每个s-t割都是一个s-t流的上界,最大流由有最小值的s-t割确定。
- 以下两个lemma证明该结论:
- 对任意流和任意s-t割,流$\leq$割:从s流出的流量
- 存在等于Ford-Fulkerson算法结果的s-t割:
- $f_{ou}(L)=c(L,R)$:跨割L-R方向流量流满,使残差图中正向边找不到s-t路径。
- $f_{in}(L)=0$:跨割R-L方向流量为0,使残差图中构造反向边时找不到s-t路径。
- 找最小割:在已经找到最大流的残差图中,从s出发能够到达的点全在L中,其余点全在
R中。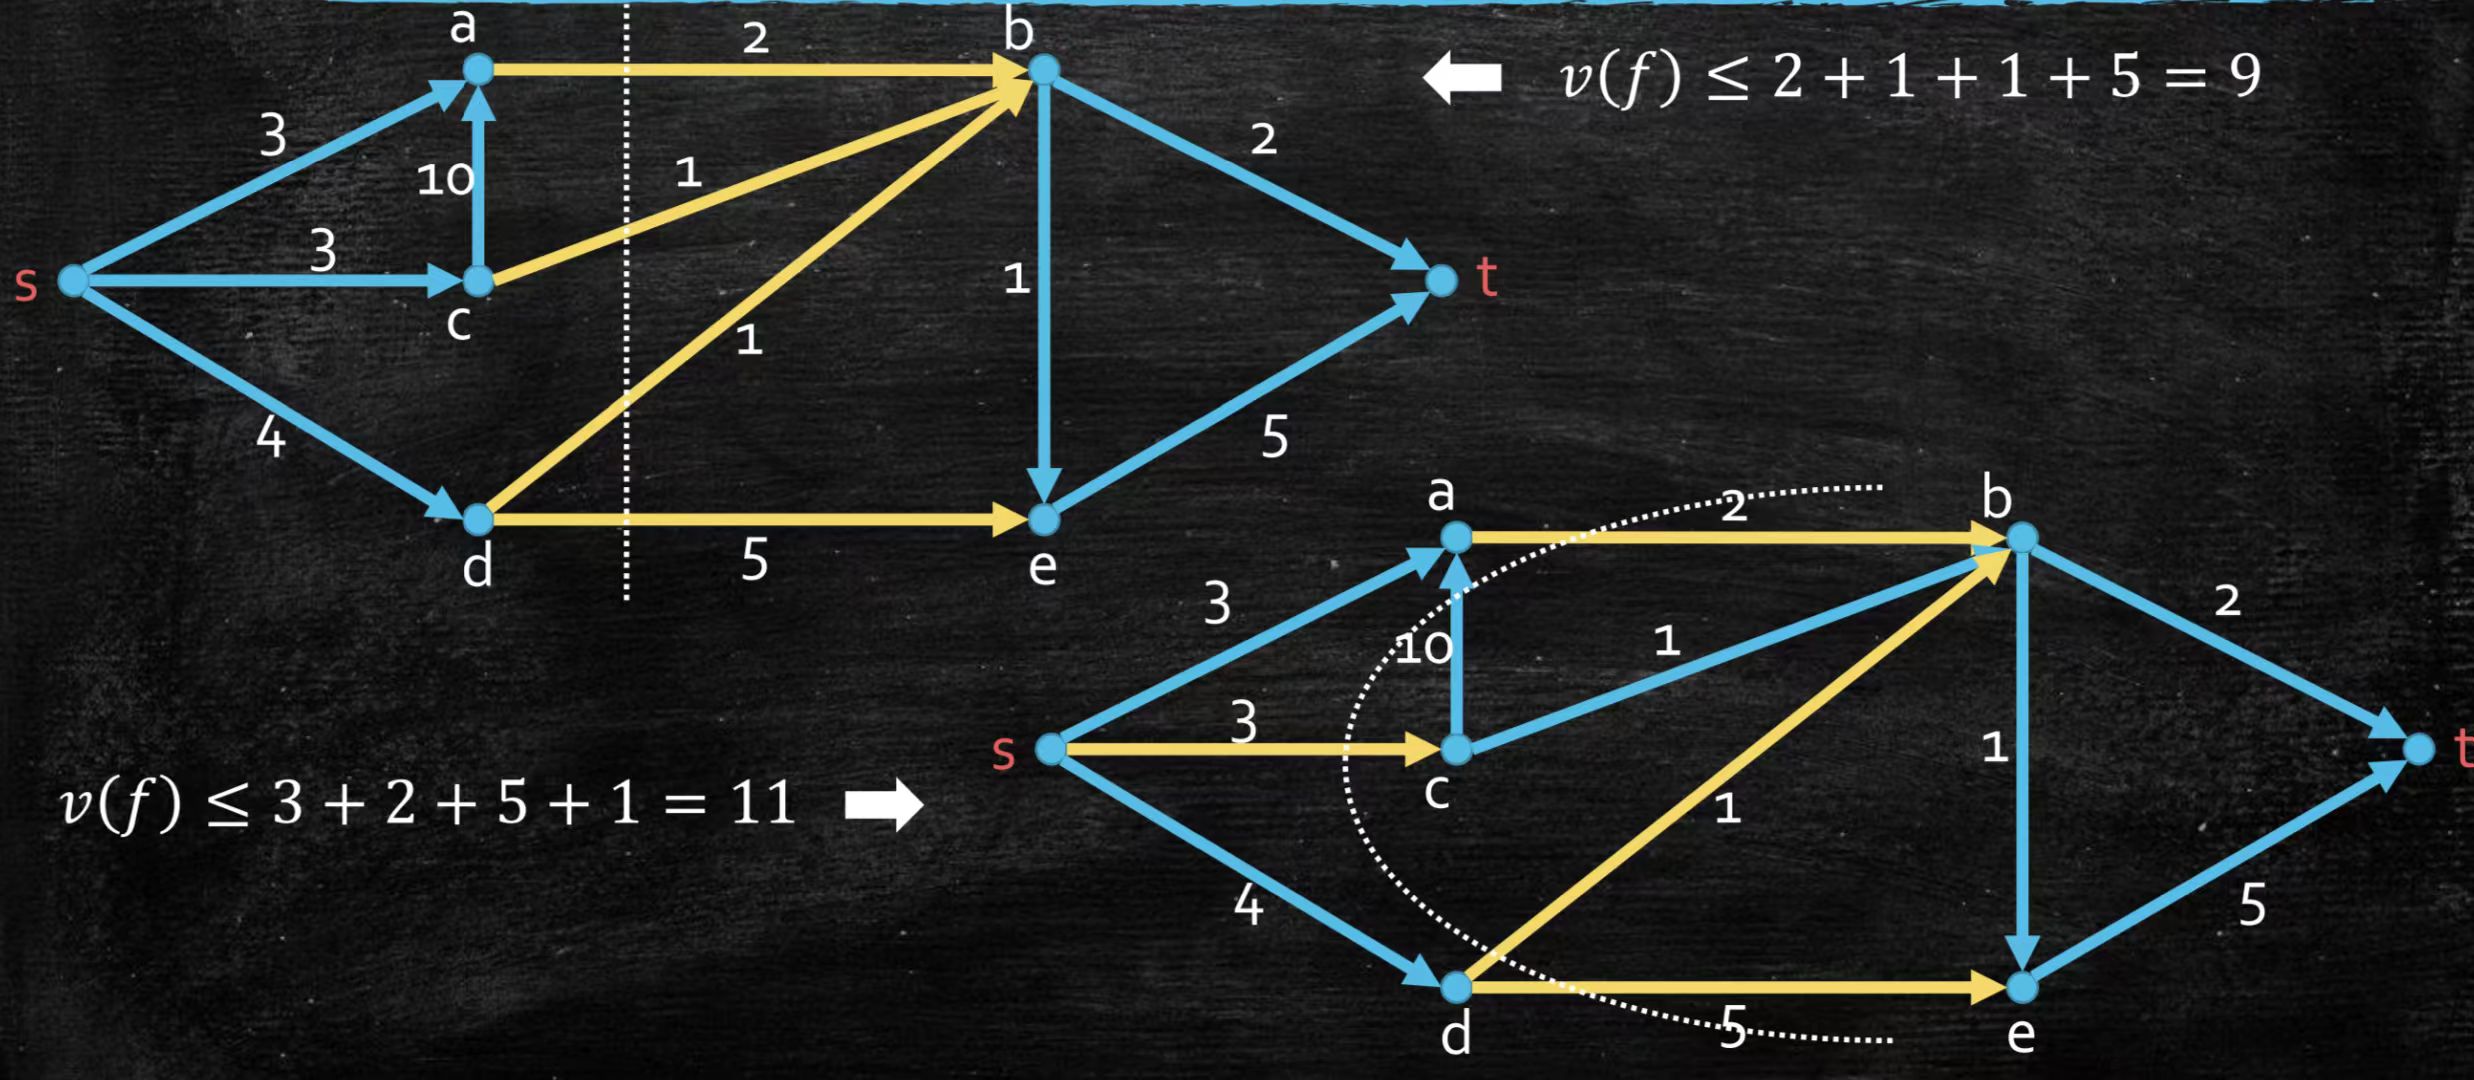
- 二分图的Hall’s Marriage Theorem:$G=(A,B,E)$,当且仅当$\forall S\subseteq A, |S|\leq |N(S)|$时,存在大小为$|A|$的匹配。$S\subseteq A$时,$N(S)$是$B$中与$S$相连的节点数。
- 以下两个lemma证明该结论:
- Edmonds-Karp Algorithm:与Ford-Fulkerson算法的区别是使用BFS找s-t路
- BFS:使用BFS相当于以节点跳数为距离由近及远地找路
- 弱单调性:每次寻路过后,$G^f$中下一条s-t路的距离是非减的。
- 强单调性:称呼路上限制流量的边为瓶颈。对同一条边(u,v)来说,第一次瓶颈使它反向,而在它第二次瓶颈前必然已经有流量通过(v,u),即u-v\v-u都被经过了,因此两次(u,v)瓶颈间必使u到s的距离至少增加2.
- 第一次瓶颈$dist^i(v)=dist^i(u)+1$
- 第二次瓶颈$dist^{i+j}(u)=dist^{i+j}(v)+1\geq dist^i(u)+2$
- 时间复杂度:$O(|V|\cdot |E|^2)$,每次BFS花|E|,距离从0到|V|,因此每条边至多当|V|/2次瓶颈。
- BFS:使用BFS相当于以节点跳数为距离由近及远地找路
- Dinitz(Dinic)’s Algorithm:对于残差图,根据节点到s的跳数建立等级图,图中只保留从低等级跨向高等级的边。在等级图中找blocking flow,以此更新流和残差图,循环
- blocking flow:对等级图从s跑完整的前向DFS,找到s-t路时删除瓶颈边,走到死胡同节点时删除该节点的所有入边
- 时间复杂度:$O(|V|^2\cdot |E|)$,由于以下的推导,每次迭代后s-t距离必然增加至少1,而距离最大为|V|,每次DFS花|E|。
- 首先有与Edmonds-Karp推导中相似的弱单调性。
- 证明强单调性:由于blocking flow的定义,若在$G^{f_{i+1}}_L$中存在与$G^{f_i}_L$中等长的路径,它一定有后者没有的边。若这条边(u,v)没在前一次残差图中,则(v,u)是瓶颈;若在残差图但没在等级图中,uv必须等级相等或u比v大。因此$dist^i(u)\geq dist^i(v)$,再结合弱单调性:
- 最大二分图匹配问题:添加s、t且将所有边权值命为1,跑Dinitz算法。时间复杂度为$O(|E|\cdot \sqrt{|V|})$:先跑$\sqrt{|V|}$轮DFS,此时路径长度已经至少为$\sqrt{|V|}$。又由于权值为1,每条边被至多一条路独占,因此剩下至多$\frac{|V|}{\sqrt{|V|}}=\sqrt{|V|}$条路,最多再跑这么多轮。
Linear Programming
- 使用强对偶性解最优解:
- 写原始和对偶LP
- 描述两个LP对应的原始问题和对偶问题
- 如果问题是离散整数的,需要证明它们有整数最优解
- 解对偶LP,再应用强对偶定理
- Simplex Method(线性优化问题):在约束条件造成的凸图形中选一个顶点作为起始点,向目标方向沿着边移动到下一个顶点,直到遇到局部最小值时停止。m个条件、n个变量时,时间复杂度为$\binom{m}{n}$。
- 标准形式LP:等式可以写成两个不等式,无约束变量如x可以用$x^+-x^-$($x^+,x^-\geq 0$)替换。把每条边上的流量作为变量,最大流问题可以写成LP。
- 对偶LP(Duality):primal LP中的每个约束条件对应一个$y_i$,乘以y相加后,不等号右边是新的目标函数,约束条件是不等号左边原变量系数不小于原目标函数中的系数、和非负性。
- 弱对偶定理:原LP和对偶LP的可行解满足$c^T\hat{x}\leq b^T\hat{y}$。
- 强对偶定理:原LP和对偶LP的最优解满足$c^T x^=b^T y^$
- LP-Relaxation:
- Integar Program(IP or ILP):加一个变量为整数的约束。是NP完全问题。可以先不管整数约束解LP问题得到近似解,再约到整数。
- Minimum Vertex Cover:
- Vertex Cover:$S\subseteq V$且$S$有所有边的至少一端。
- IP形式:
- Relaxation to LP:$x_v\in {0,1}\rightarrow 0\leq x_v\leq 1$,而$OPT(IP)\geq OPT(LP)$,解LP问题,返回$S={v|x_v^\geq\frac{1}{2}}$。该算法近似为2,因为$OPT=OPT(LP)=\sum\limits_{v\in V}x_v^=\sum\limits_{v:x_v^<1/2}x_v^+\sum\limits_{v:x_v^\geq 1/2}x_v^\geq 0 + \sum\limits_{v:x_v^*\geq 1/2}\frac{1}{2}=\frac{1}{2}\cdot |S|=OPT(IP)$
- 对偶问题类似最大二元匹配:Ranking Algorithm,赋予A中所有节点一个0到1间的排序值,B中所有节点greedily选择有最小排序值的相邻节点匹配。期望$E(ALG)\geq (1-1/e)OPT$。
- 由于强对偶定理只对OPT有效,当且仅当IP及其Dual都有整数最优解时,强对偶定理对它有效。
- 整数最优解的条件:标准LP问题中约束条件A是幺模矩阵(unimodular),当原问题中b为整数则有整数最优解,c为整数则对偶问题有整数最优解。简单来说,LP及其dual均有整数最优解要求A为幺模矩阵、bc为整数。
- 幺模矩阵:每个方形子矩阵的特征值在{0,1,-1}中。
- 证明幺模矩阵:归纳法,base是每个元素都是0-1\1,归纳是从k x k到 (k+1) x (k+1),讨论一行是全0、一个非0、每行都有两个非0则列运算即可。
- 最大流问题:
- LP形式:
- 对偶问题:
- von Neumann’s Minimax Theorem:说明了零和博弈中谁先选择策略不重要,是强对偶定理的引申。
NP-Completeness
- 证明某问题(f)NP-complete的标准步骤:
- 证明f是一个NP问题
- 选择合适的其他NP-complete问题g作为基准,尽量找相近的
- 证明f比g Karp难
- 证明g的yes实例可以对应f的yes实例
- 证明g的no实例可以对应f的no实例,更简单的是证明它的逆否命题(contrapositive),即证明如果g的实例x可以映射到f的yes实例、x就是g的yes实例
- 如果已知g但f与g相差甚远,可以再找个中间问题h
先备知识:
- 常见NP-hard问题:SAT(CNF合取范式)、Vertex Cover、Independent Set、Subset Sum、Hamiltonian Path。
- 决定问题:$f:\sum^*\rightarrow {0,1}$,简单的决定问题应当存在多项式时间内结束的算法$\mathcal A$。
- 此处用图灵机表示算法,图灵机与常见的C语言式算法总能在同样的问题上有多项式时间算法:
- 纸带:无限内存
- 纸带上的移动指针
- 符号集
- 状态集:算法的不同阶段
- 状态转移函数:状态间的转移、移动指针
- 开始状态:纸带上写入输入、指针指向纸带头
- 终止状态:接受或拒绝
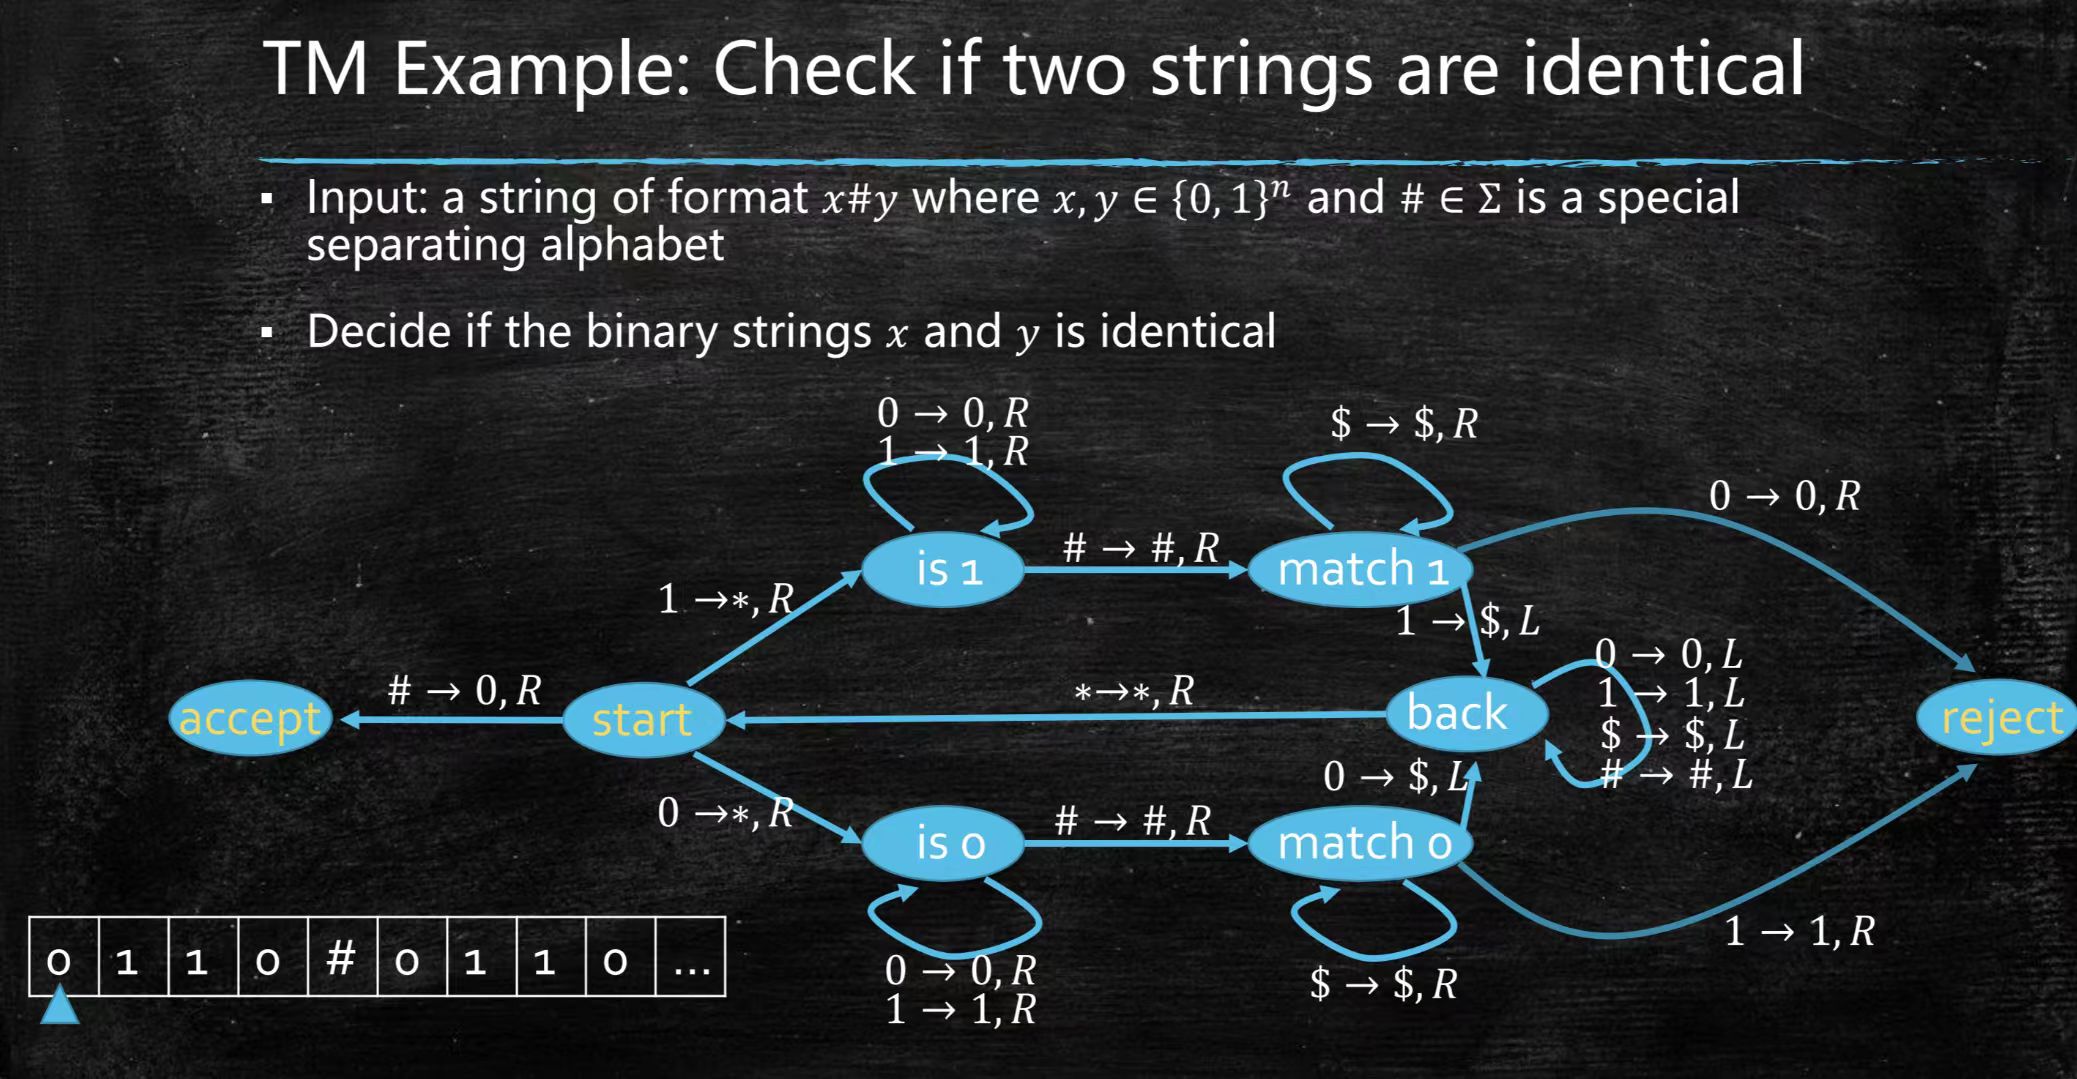
- 理性搜索问题:
- 搜索:难
- 验证:简单
复杂度类:
- 复杂度类P:存在多项式时间图灵机(算法)的决定问题。常见的P问题如判断图中两点间是否存在路径、判断图中是否可以存在至少为k的流量、判断k是否为质数,这类问题被认为是简单的。
- 复杂度类NP:存在多项式时间内结束的验证图灵机(算法)$\mathcal A(verifier)$的决定问题。常见问题如上述所有NP-hard问题。注意我们的输入还需要包括一个待检结果(certificate,常用y表示)。
- $P\subseteq NP$:可以基于P的算法$\mathcal A$构建忽略y的算法,当P的结果为1时,认为y是空集(零输入);当结果为0时,对任意y均被拒绝。
- Karp Reduction:一个决定问题f Karp reduce to 另一个决定问题g,即$f\leq_k g$
- 目的:证明一个问题比另一个问题稍难,则能通过已知问题所属的复杂度类推知其他问题的复杂度类。例如$SAT\leq_k 3SAT$
- 条件:存在满足多项式时间图灵机$\mathcal A$能转换两个问题的结果,使
- 输入f的yes实例能输出g的yes实例
- 输入f的no实例能输出g的no实例
- 传递性
- 最难的问题:
- NP-hard:比NP中的所有问题都Karp难
- NP-complete:比NP中所有问题都Karp难且自身属于NP。SAT是NP-complete问题,这是证明许多问题NP-complete的起点,即比SAT都Karp难的NP问题必然NP-complete。而解出NP-complete问题意味着NP-complete属于P,即证明了P=NP。
- 应用:关键是找出两个问题解间的关系
- Independent Set $\leq_k$ Vertex Cover:G=(V,E),S是G的独立集时,V-S就是G的顶点覆盖。故结果转换图灵机只需独立集输入实例(G,k)$\rightarrow$顶点覆盖输入(G,|V|-k),转换后输入Vertex Cover Solver。
- Independent Set $\leq_k$ Clique:只需将前者输入实例的图改为全连接图$\overline{G}$。
- 更多NP-complete问题:
- Dominating Set:G中的一个节点集合S,G的节点要么在S中,要么与S中某个节点相邻。可以从Vertex Cover出发,将G在边上新增节点并将旧节点相互全连接得到G’,(G’,y)就是一个Dominating Set的yes实例。
- Hamiltonian Path:3SAT $\leq_k$ DirectedHamiltonianPath $\leq_k$ HamiltonianPath。
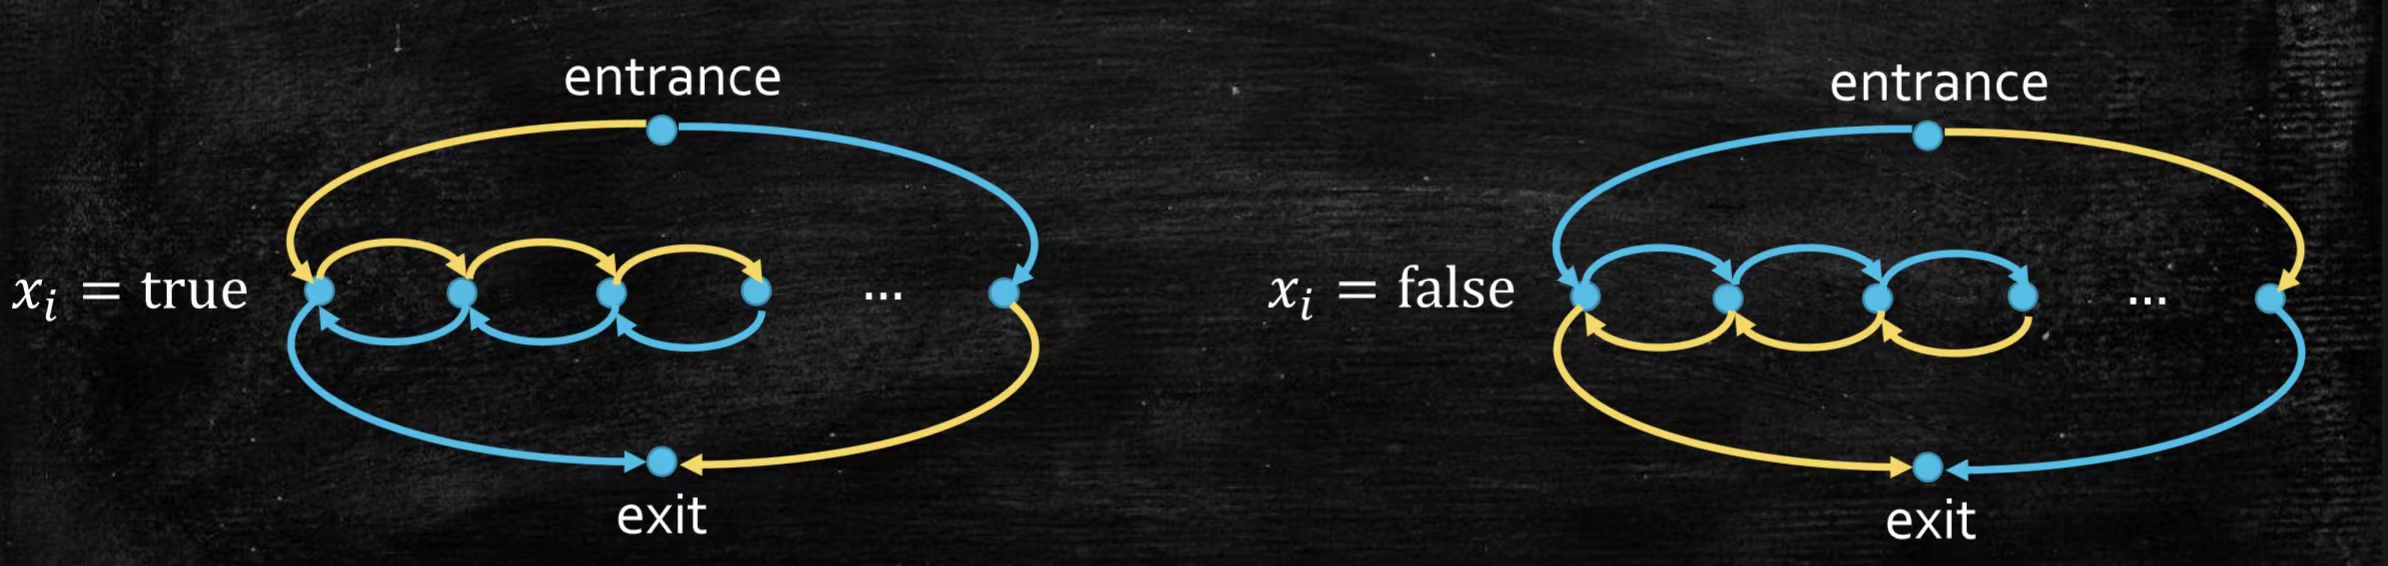
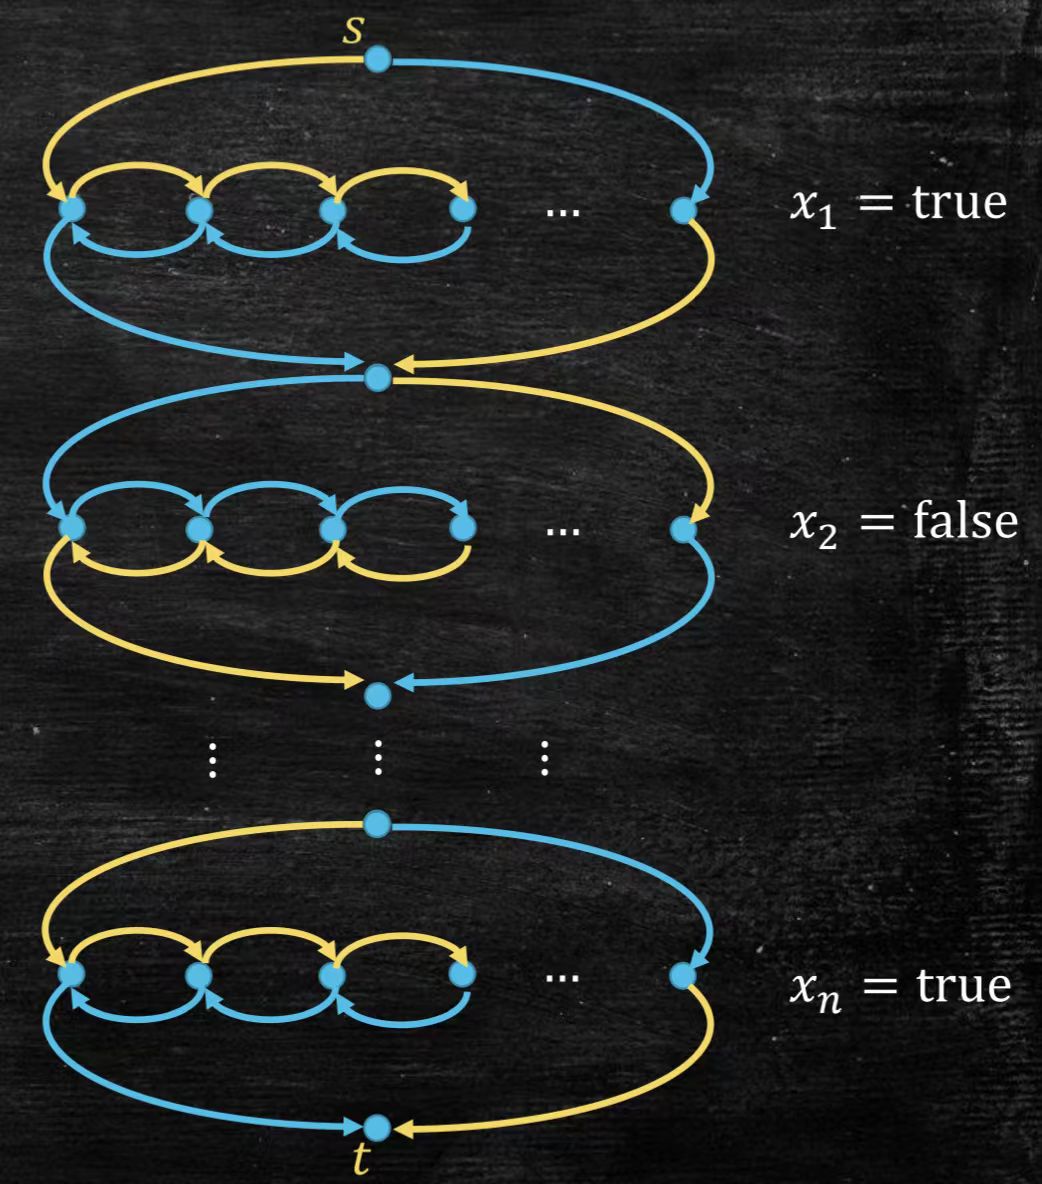
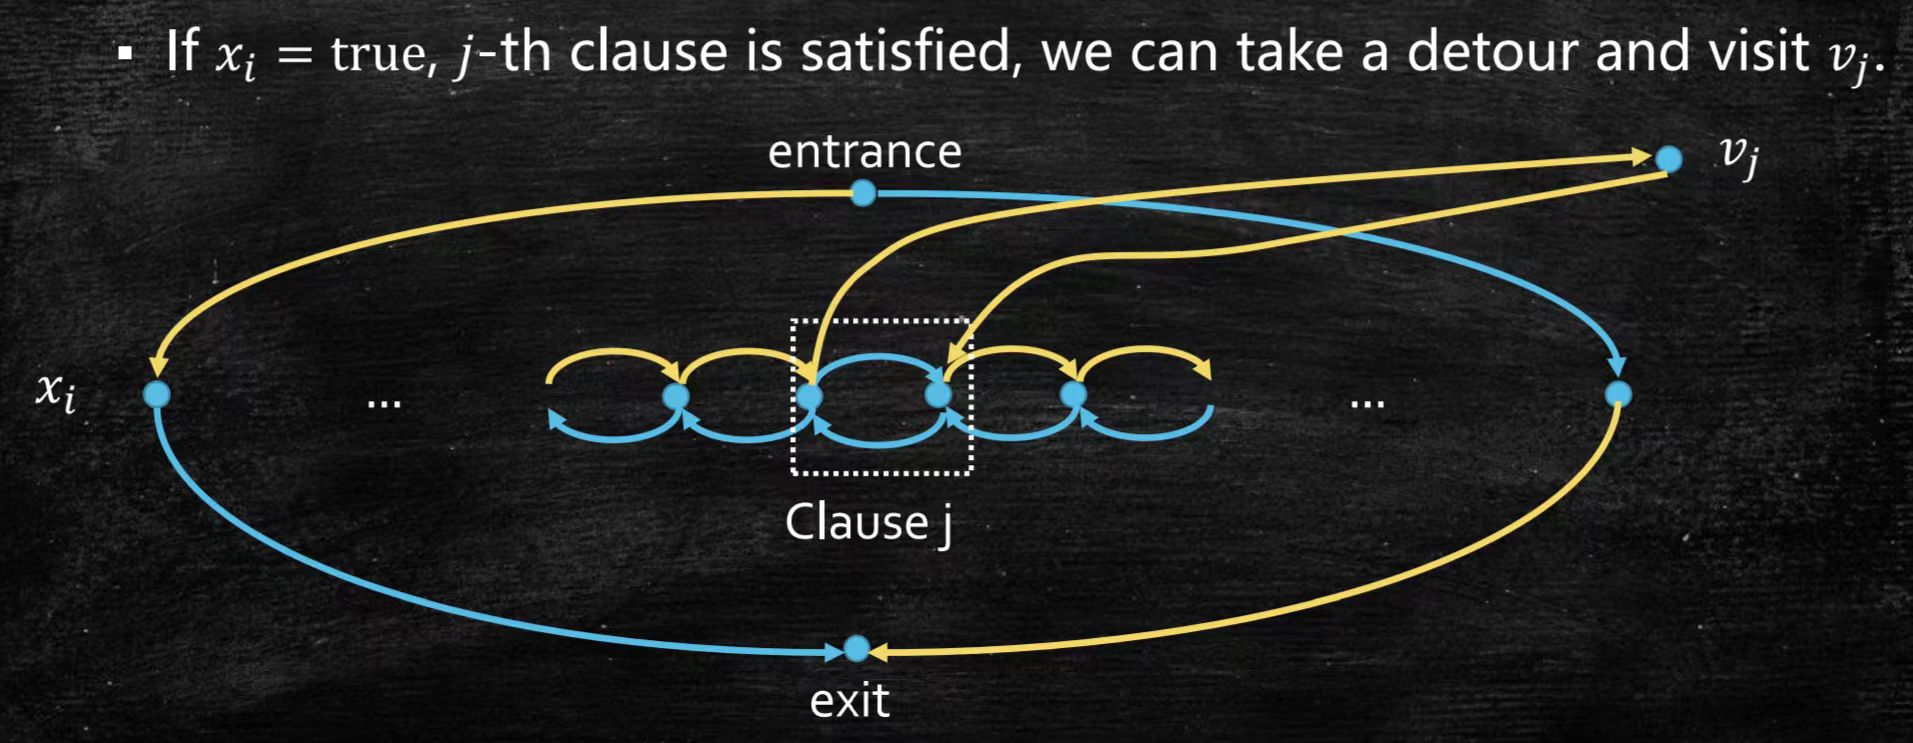
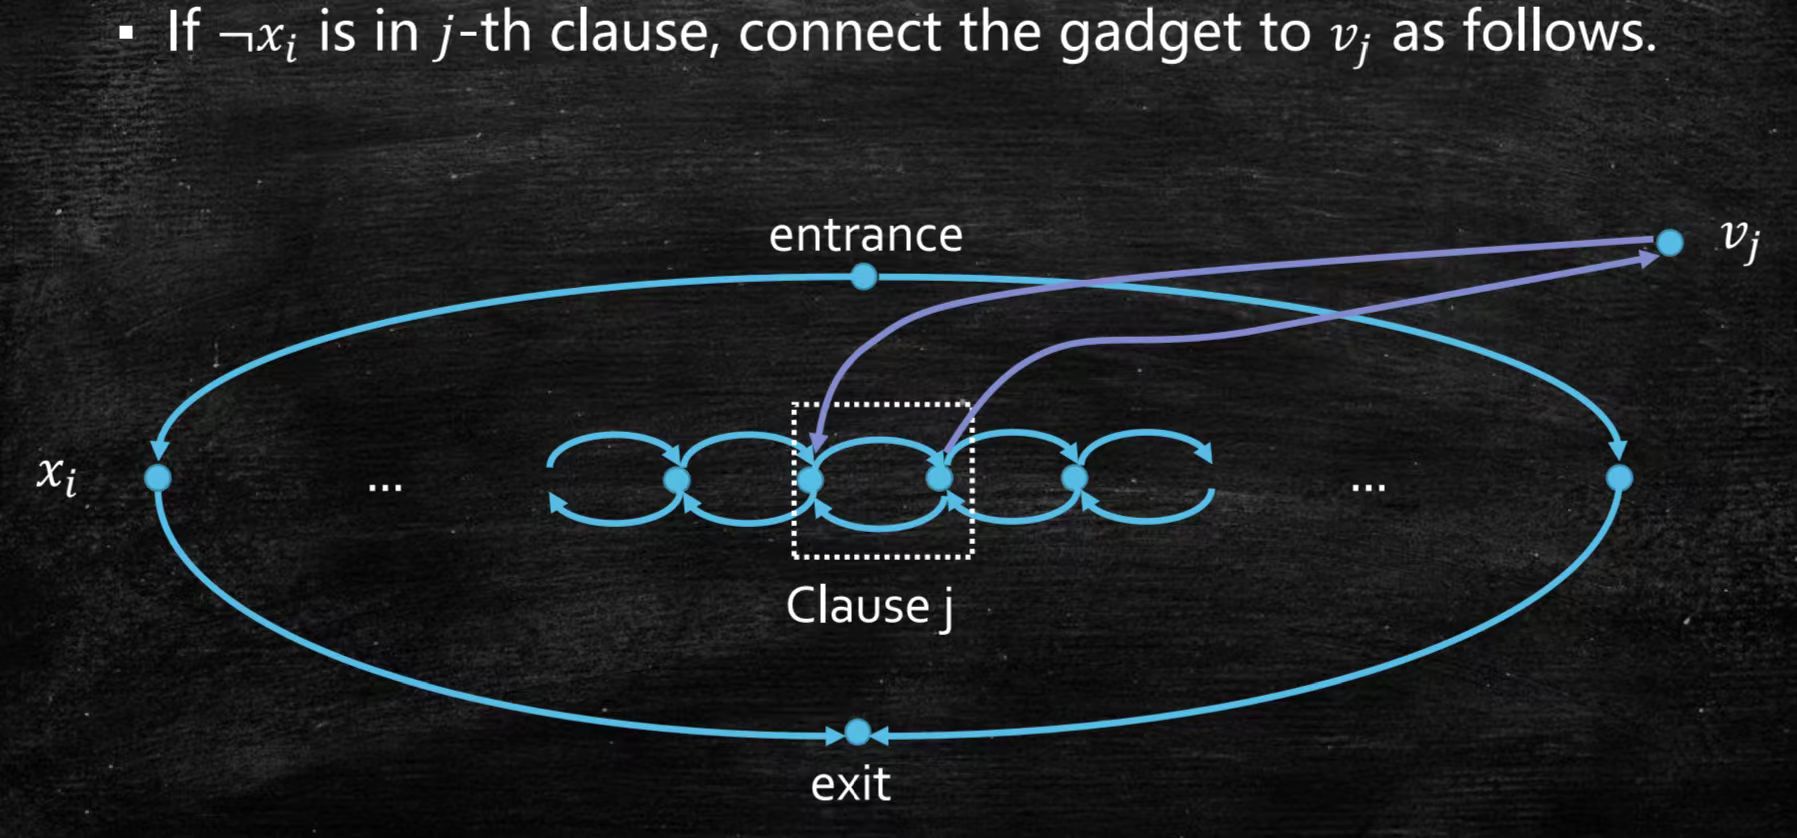
- 3SAT $\leq_k$ DirectedHamiltonianPath:用两个节点的环表示clause,用许多个clause相连(表示该变量在某个clause中)以及出入口来表示一个变量,从入口到出口走一个方向为true、另一个方向为false;此外用通过一个独立于变量外的节点表示该一个3SAT-clause被解决了(被某个变量定为true),该节点被括号内含有的变量内的双节点环连接,非变量反向连接。
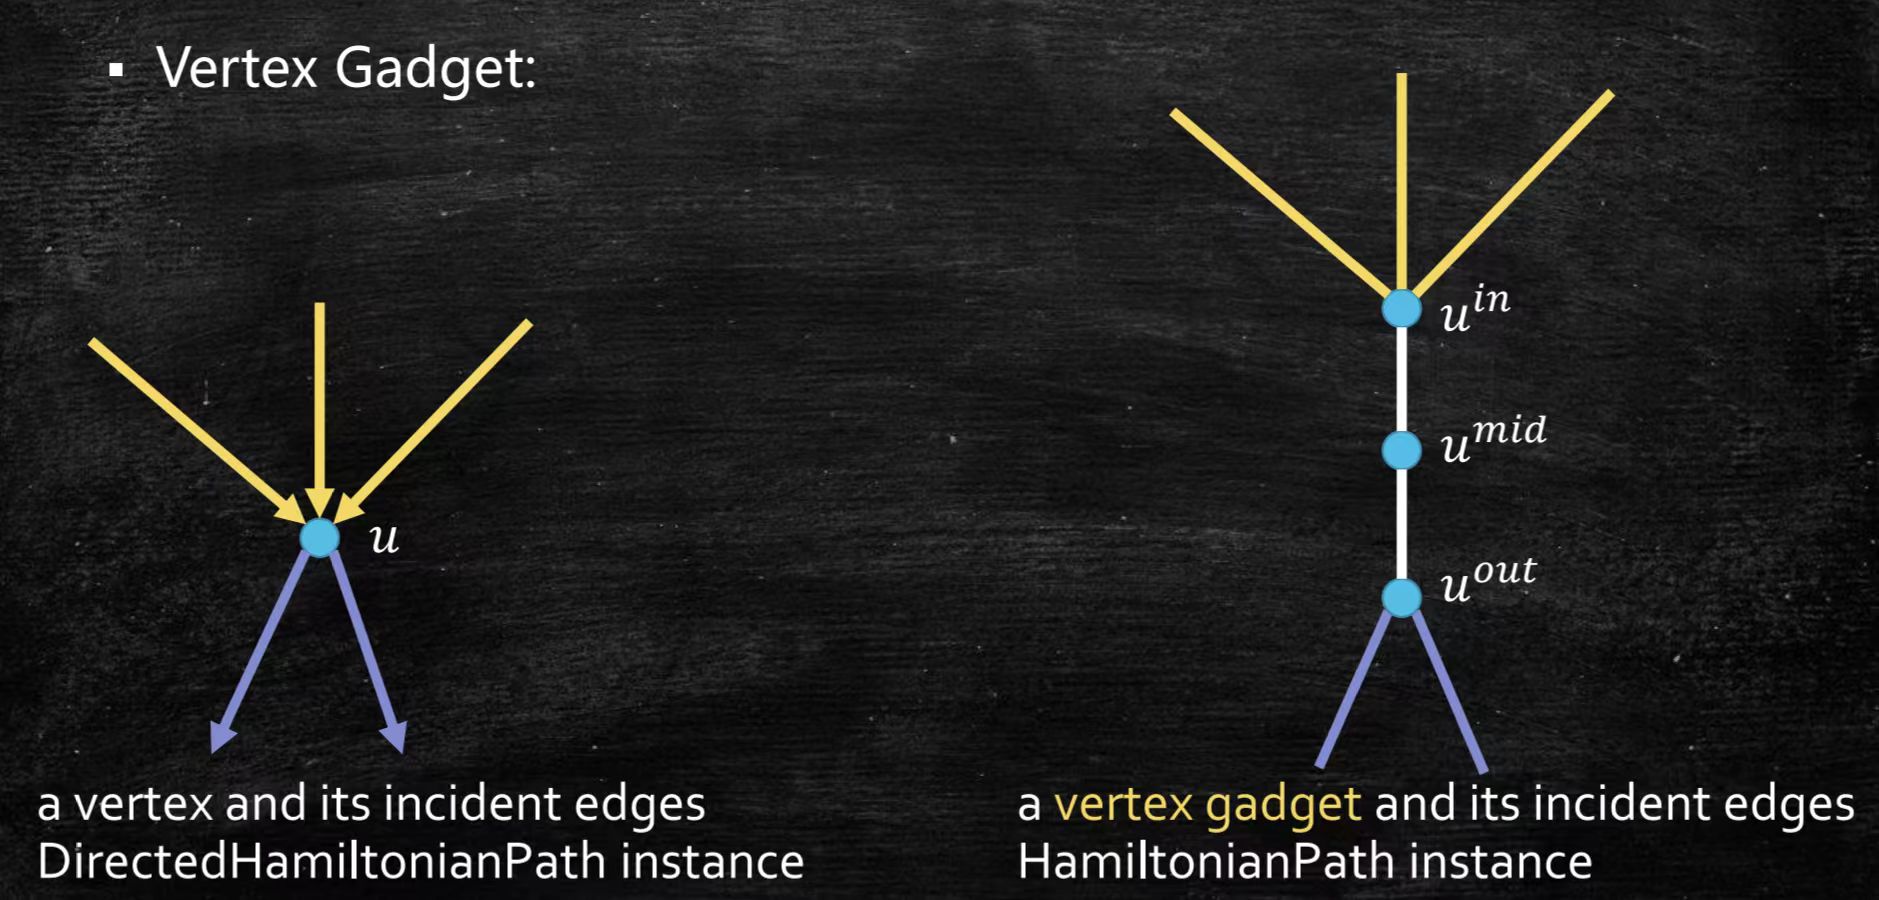
- DirectedHamiltonianPath $\leq_k$ HamiltonianPath:将有向图转换成无向图,具体是将有向图的一个点拆成三个点分别接收入边、出边和保证经过的中间点。路从出边进来也没事,此时整条路都会反。
- 3SAT $\leq_k$ DirectedHamiltonianPath:用两个节点的环表示clause,用许多个clause相连(表示该变量在某个clause中)以及出入口来表示一个变量,从入口到出口走一个方向为true、另一个方向为false;此外用通过一个独立于变量外的节点表示该一个3SAT-clause被解决了(被某个变量定为true),该节点被括号内含有的变量内的双节点环连接,非变量反向连接。
猫才毛
Live for what I love ~
24
8
5