参考课程:
- AI3603 SJTU
- CMU 15-281
搜索
总思路:
- state
- action
- openlist
- engineering
A*算法
对路径点$n$的评估采用$f(n)=g(n)+h(n)$,其中:
- $g(n)$表示从起点到n的实际距离。
- $h(n)$表示从n到终点的估算距离,常用如欧氏距离、曼哈顿距离(坐标轴平行距离)等,可自定义。
- $h(n)$要求Admissible(小于等于实际最优距离)、Consistency(任意两点间的启发式距离小于等于实际最优距离)
- 在树上只要Admissible即可最优,图上则还要Consistency
与其他算法比较:
- 如果$h(n)$为0,该算法退化为Dijkstra算法;
- 如果$g(n)$为0,该算法退化为只考虑与终点距离的纯贪婪算法。
1 | |
Minimax
零和游戏中,为了做出最佳决策,在有限种情况时,考虑递归地构建所谓决策树。
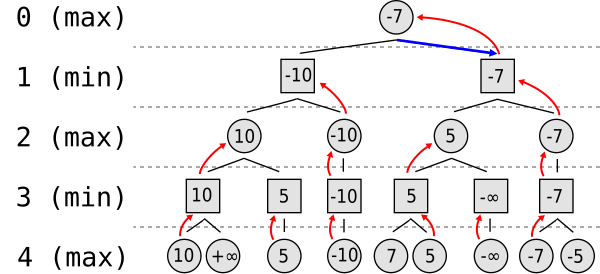
首先我们需要最大化自己的收益,即树根节点,从而需要在各种情况即第一层子节点中选择,而第一层子节点一般是对手的决策。但理想情况下,对手会选择最大化他的收益、即最小化我们的收益的决策。从而以上分析可以写为:
其中$a_0$是我们第一层决策,$a_{-0}$是对手的第一层决策。
Minimax算法就是考虑自己和对手的每一层决策,在所有可能中选择最大化己方收益。可以直观地用递归算法表示:
1 | |
在此基础上,我们还可启发式地引入Alpha-Beta剪枝。其想法是考虑某个需要最大化收益的节点时,其某些子节点的值已经比考虑过的子节点的结果要小,我们可以放心地不去考虑这些已经比较小的子节点的子树,最小化收益节点同理。例如以下树:
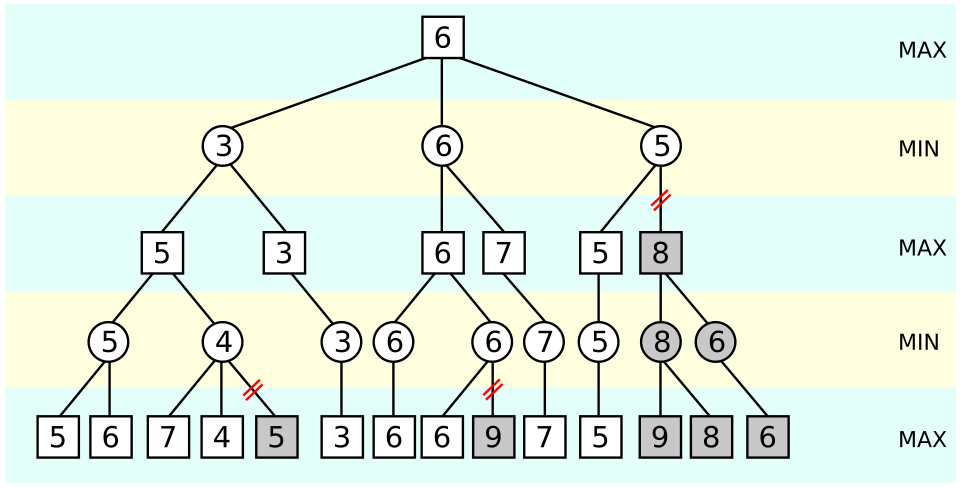
在算法实现中,我们会设置两个全局变量$\alpha$和$\beta$分别表示已考虑的最大化节点中的最大收益和已考虑的最小化节点中的最小收益。在最大化节点中,我们可以将子节点收益与$\beta$进行比较,即与最大化节点的父节点(最小化节点)的最小收益(最优情况)相比较,显然如果比它大,该子节点就不会被采用,进而排在它后面的其他子节点就不用考虑了。最小化节点也类似,综合起来可以写成如下递归算法:
1 | |
Hybrid A*
用于无人车自动驾驶的改进版A*算法,它考虑了车有朝向和必须转弯的刚体特性,设计了独特的决策模型。车的刚体模型如下图:
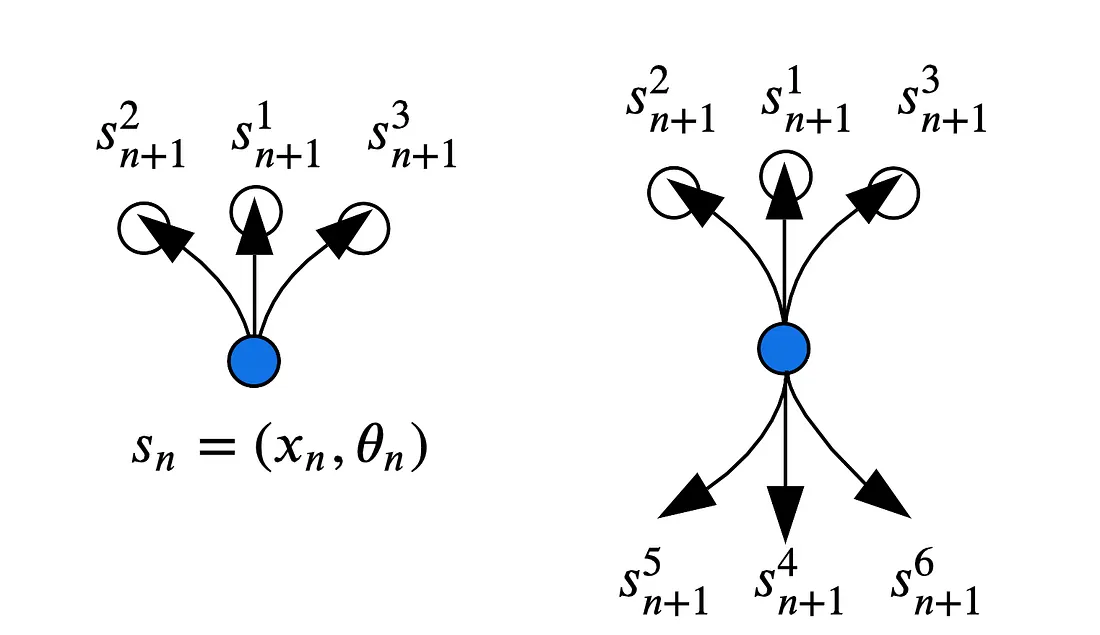
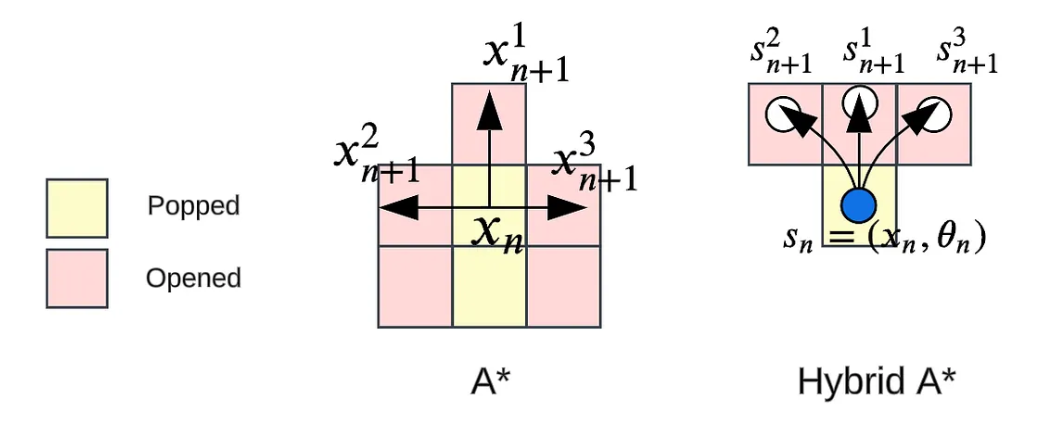
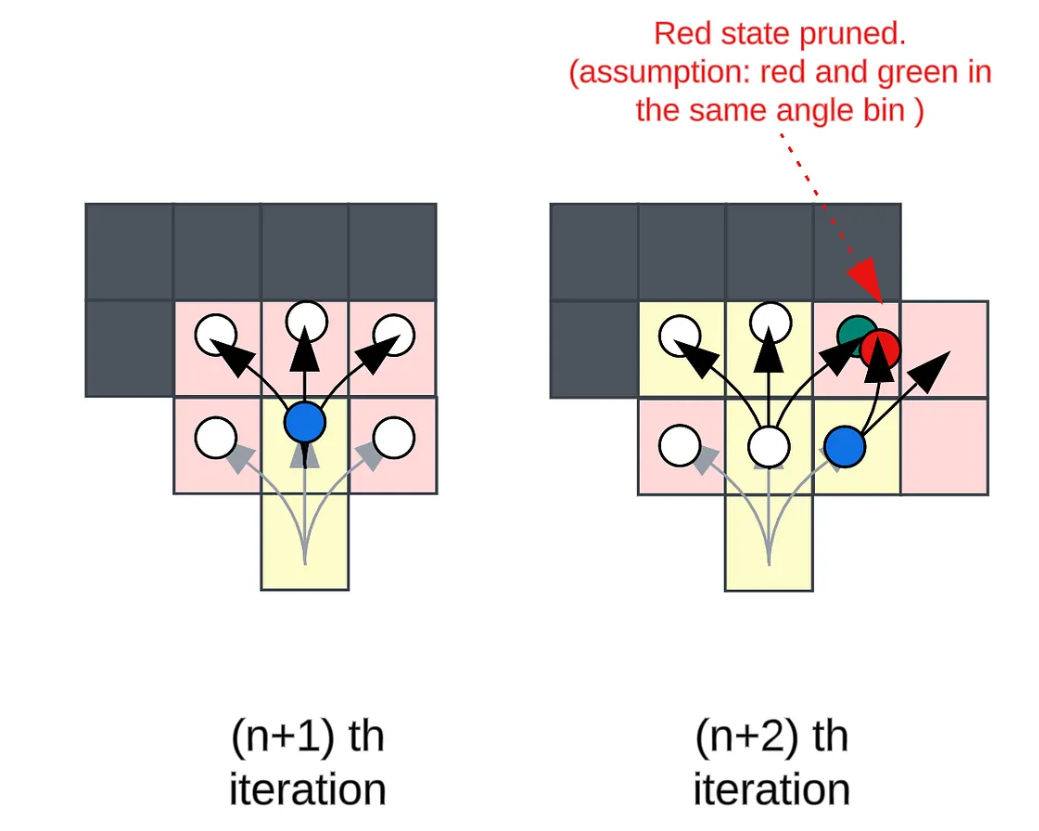
转向角度和当前位置会被离散化,方便构建有限的决策树。由此,该模型中每一步新的openlist将会与naive A*不同:
有时可能两种不同的决策会使小车走到同一位置,我们可以通过比如给予转向更少的奖励等手段,剪枝其他决策:
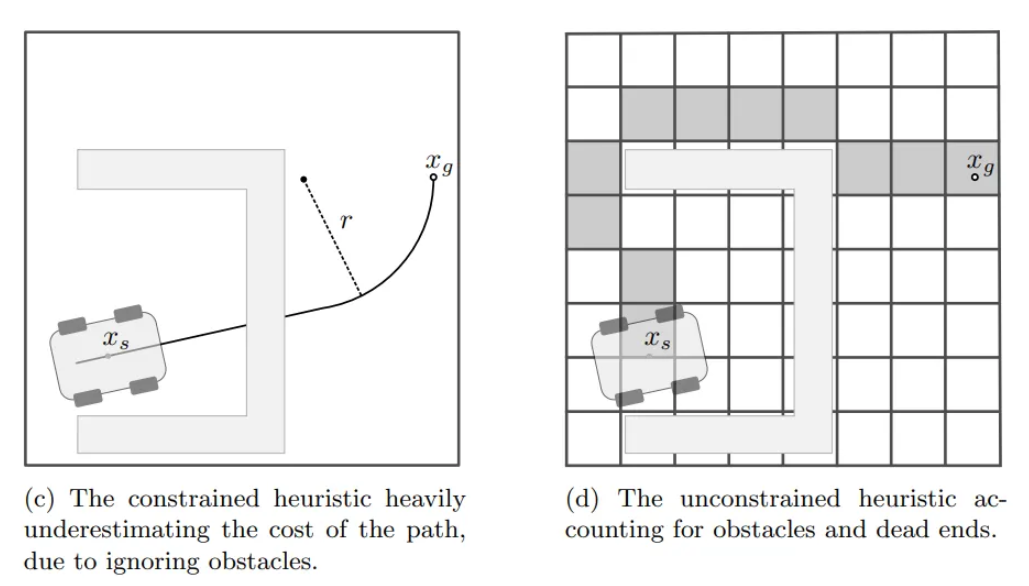
最后,启发函数既需要考虑车的刚体特性,还需要考虑路上可能的障碍物。原论文作者Karl的选择是取不考虑障碍物、仅有刚体特性的Dubins Path或者Reeds-Shepp Path(考虑倒车的前者),和仅考虑障碍物的naive A*两种启发式函数中的较大值。两种启发式函数示意图如下:
CSP问题与Backtracking
Constraint Satisfaction Problems(CSP)是搜索问题的一种,它有着有限的变量、有限的值域和描述了可用子集(一组变量赋值为一个状态)的清晰的约束条件。典型问题有染色问题、排时间表等等。可以将需要赋值的变量视作节点、约束条件视作边,就可以得到一个CSP图。
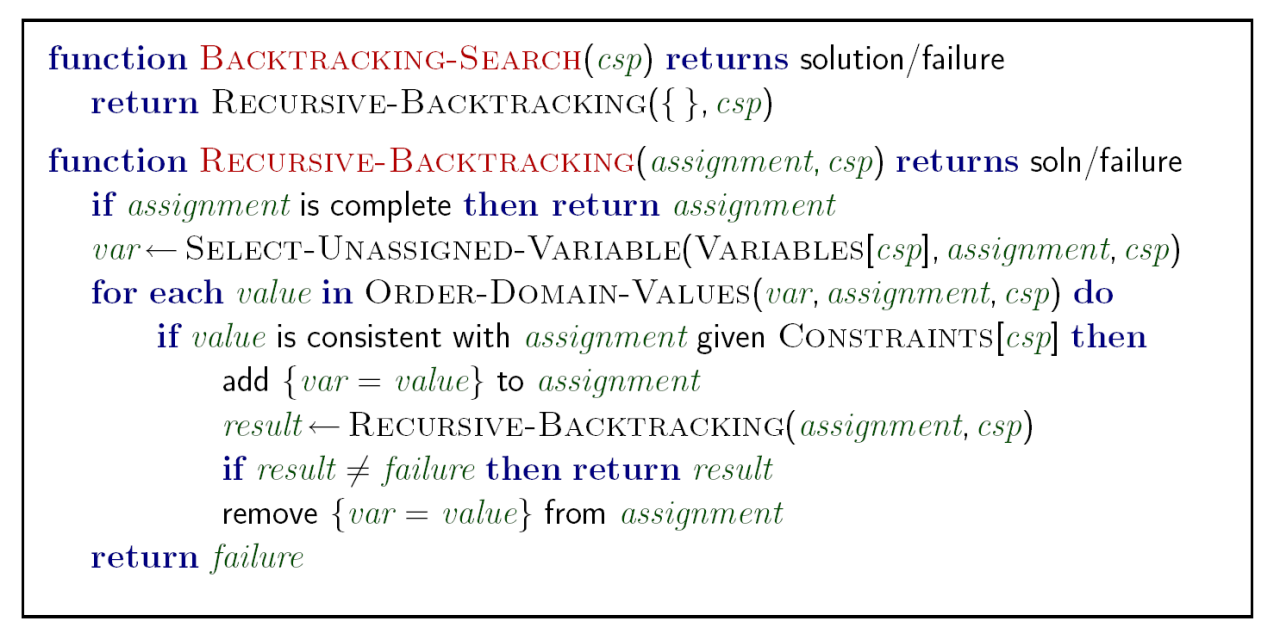
暴力解法为Backtracking(回溯法),即每步给一个变量赋值,检查是否满足约束,不满足则更换赋值甚至往回给上个变量赋值。算法如下:
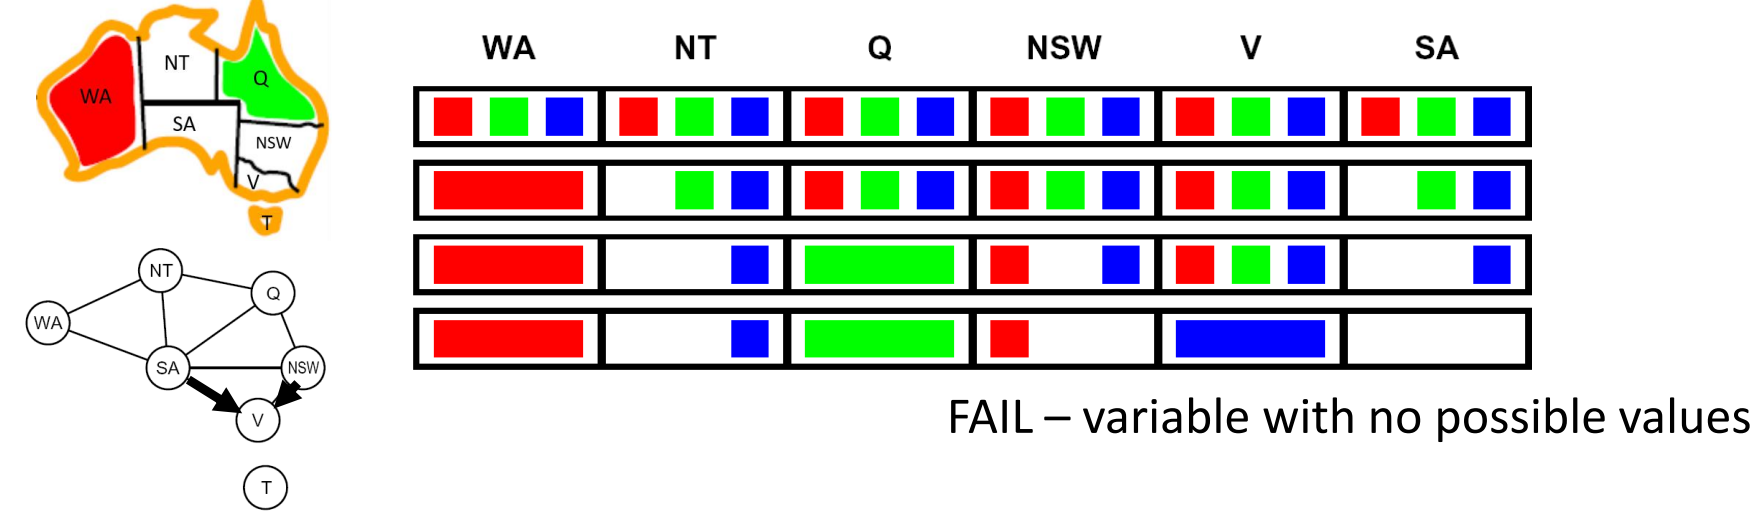
这样做最坏情况需要遍历所有状态,我们希望预知失败,这些方法称为Filtering。一种简单的Filtering改进是Forward Checking,每给一个变量赋值,我们检查相关约束条件,并更新下个变量可用的值域,这样当可用值域为空集但仍有未赋值变量时就失败了。下面是一个例子:
更进一步,在每一步赋值时,我们还可以检查每两个变量之间的约束条件从而提前发现冲突,这种Filtering方法称为Arc Consistency:
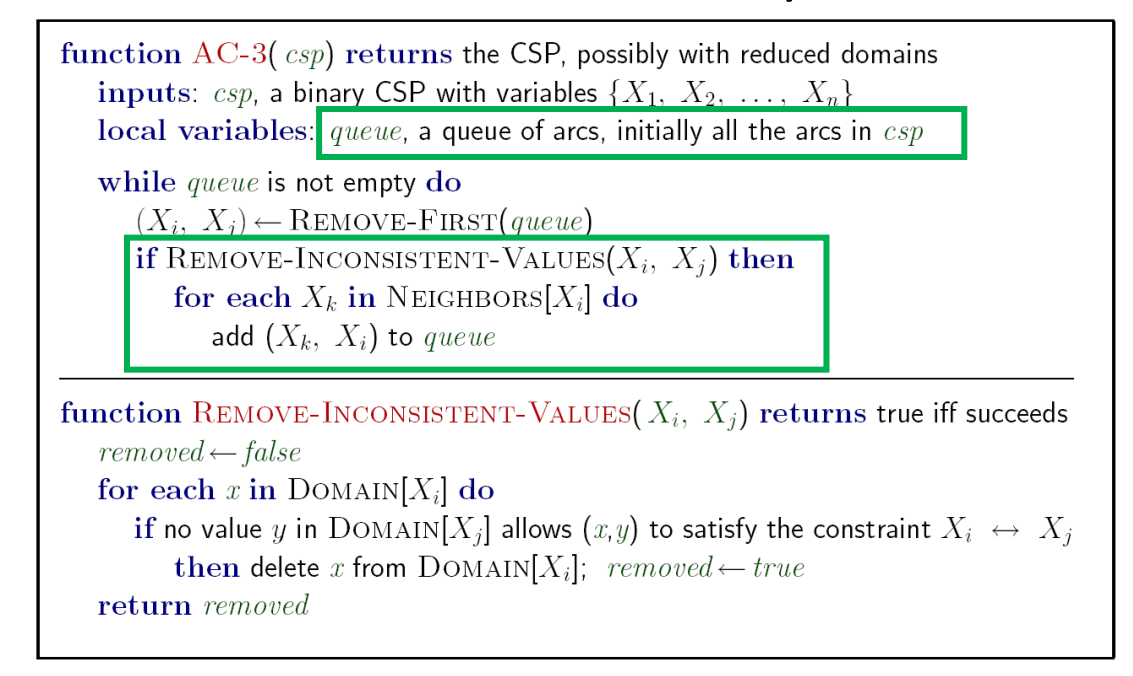
其缺点是只检查两两间约束而忽略全局,时间复杂度高且仍在Backtracking的框架中。
此外,我们可以引入变量Ordering来加速发现失败,比如Minimum Remaining Values(MRV)优先给那些值域最窄的变量赋值、Least Constraining Value(LCV)为变量赋予最少削减其他变量值域的值。
一般的CSP问题使用回溯法时间复杂度最差为$O(d^n)$(d为值域大小,n为变量数),而无环树状CSP时间复杂度最差为$O(nd^2)$(回溯最差$O(nd^2)=O(n)\; arcs \cdot O(d^2) \; backtracking$,赋值最差$O(nd)=O(n)\; nodes \cdot O(d) \; values$)。
总结来说,CSP问题的基础算法为Backtracking,可以使用Filtering(Forward Checking\AC-3), Ordering(MRV\LCV), Special Structure等技巧加速算法。
Local Search
常用于解决CSP问题(如n皇后问题),但是它通常只记录最佳状态而非全局考虑,目的是在大型问题中以较少的内存寻找一个可以接受的解。对于LS算法,我们用Complete和Optimal评价其解题能力。我们也经常会绘制问题的状态空间示意图(如下)来观察算法的可行性:
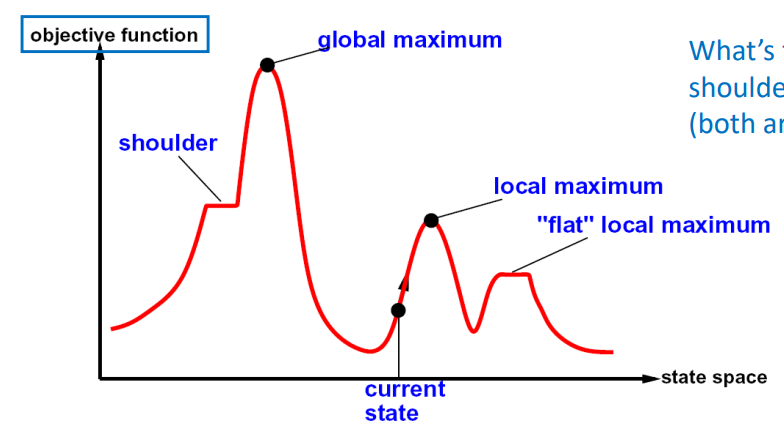
- Complete:如果存在解,算法一定能找到一个解。通常LS算法都是不完备的,就算最优解存在也可能会卡在局部最优解或者平坦高原。
- Optimal:理论保证总能找到最优解。
- 迭代优化:从随机状态出发,迭代地为变量重赋值。比如随机选择造成冲突的变量,为其挑选造成冲突最少的值,直到问题解决。会卡在局部最优解而不完备。
(Steeping-ascent)Hill Climbing:从随机状态出发,贪婪地选择最好的相邻状态直到局部最优解。显然不完备。该算法有许多变种,如局部最优时就从别的起点重新开始的Random-restart Hill Climbing(完备)、根据梯度大小随机选择邻域的Stochastic Hill Climbing、选择第一个更优邻域的First-choice Hill Climbing。
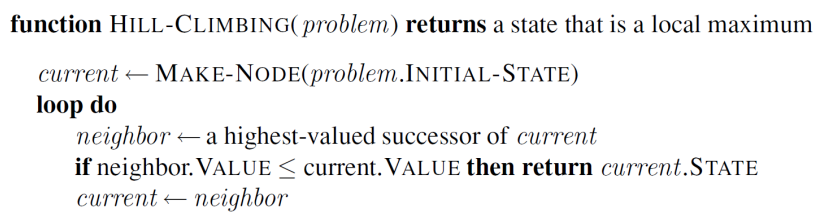
- Random Walk:均匀随机选择邻域。完备但低效。
Simulated Annealing:随机选择邻域,但以一定概率选择表现更差的邻域,概率由温度决定,而温度会以一定曲线随迭代轮数下降。灵感来源于钢铁退火。理论上温度无限时完备且高效。
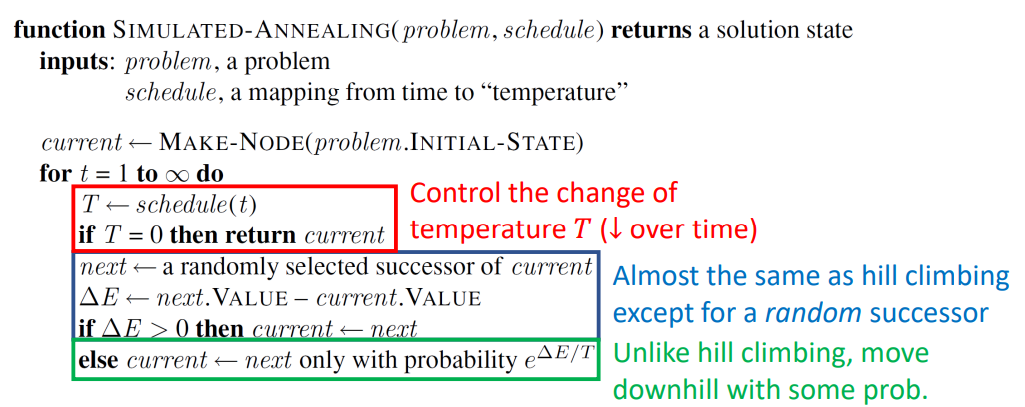
Local Beam Search:追踪k个状态,每轮选择这k个状态的所有邻域中最好的k个状态。不完备且状态容易聚集。变种如根据表现随机选择k个邻域的Stochastic Beam Search。
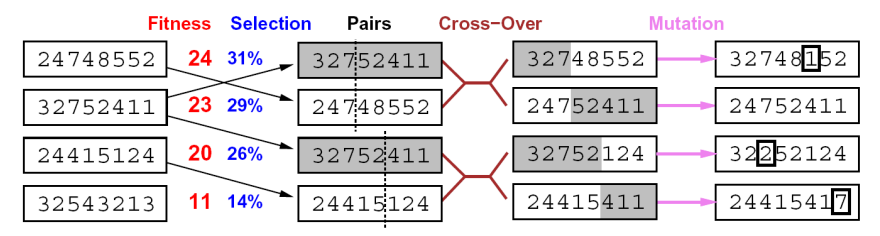
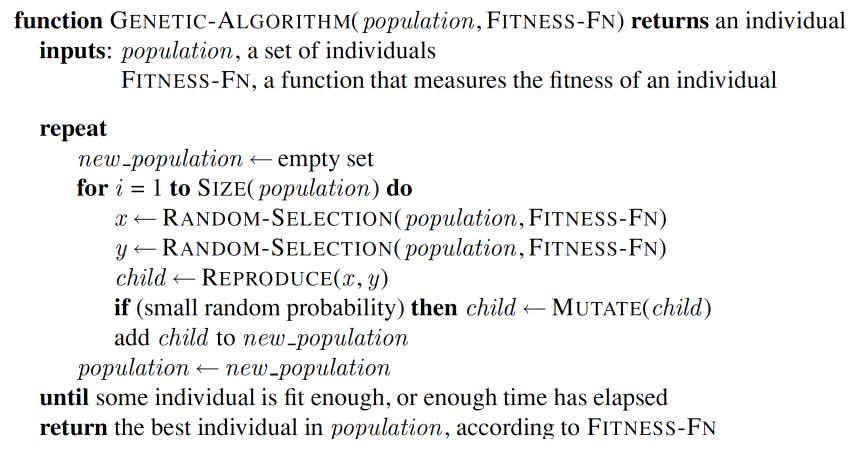
Genetic Algorithms:将状态表达为统一长度编码,从k个状态开始,每次依照表现(Fitness)选择k对父母,每对父母通过交叉(Crossover)产生子嗣,子嗣的编码以一定概率发生变异(Mutation),灵感来源于达尔文进化论。算法的效果取决于Fitness、Selection、Crossover(如PMX、OX)、Mutation(如旅行商问题中可以用简单的编码内交换)等操作的设计水平。轮次有限时不完备。
Reinforcement Learning
Markov Decision Process(MDP)
强化学习经常可以看成MDP,即每一步行动仅根据当下的状态而选择。MDP中需要理解的概念如下:
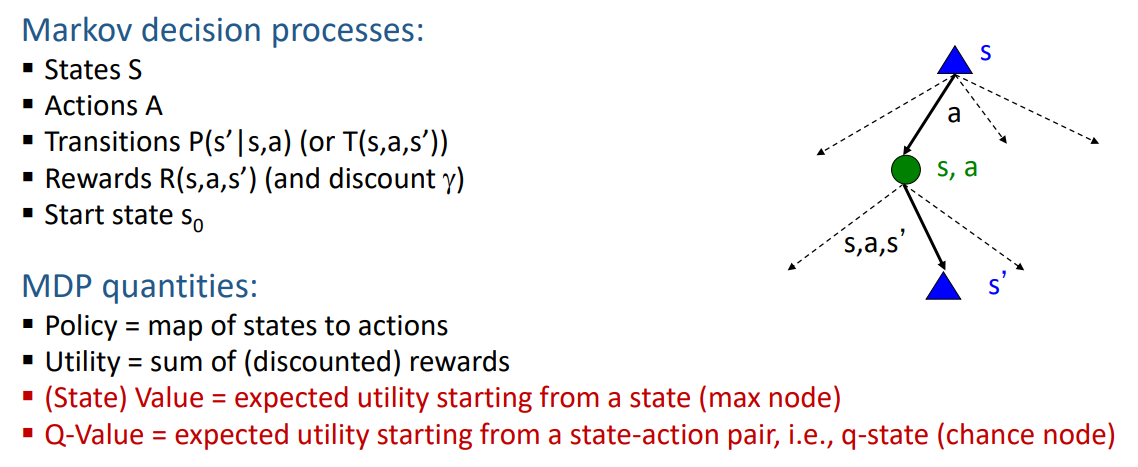
与之相伴的还有经常被使用的Discount(奖励随步数指数下降)和常见的Noise(有一定概率不选择最佳策略)。
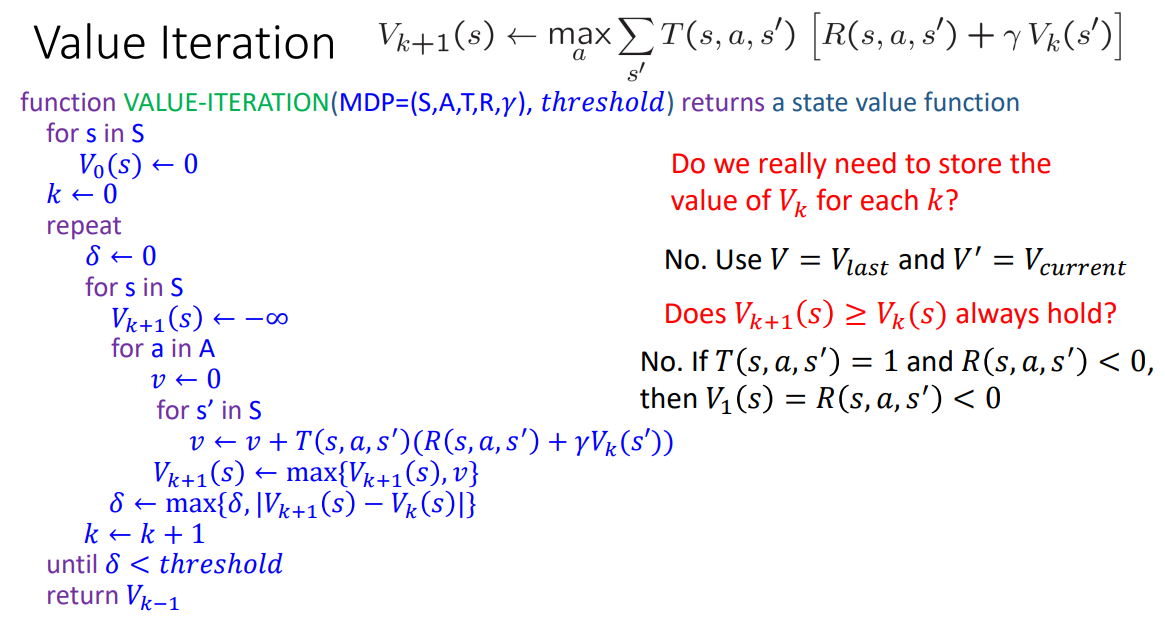
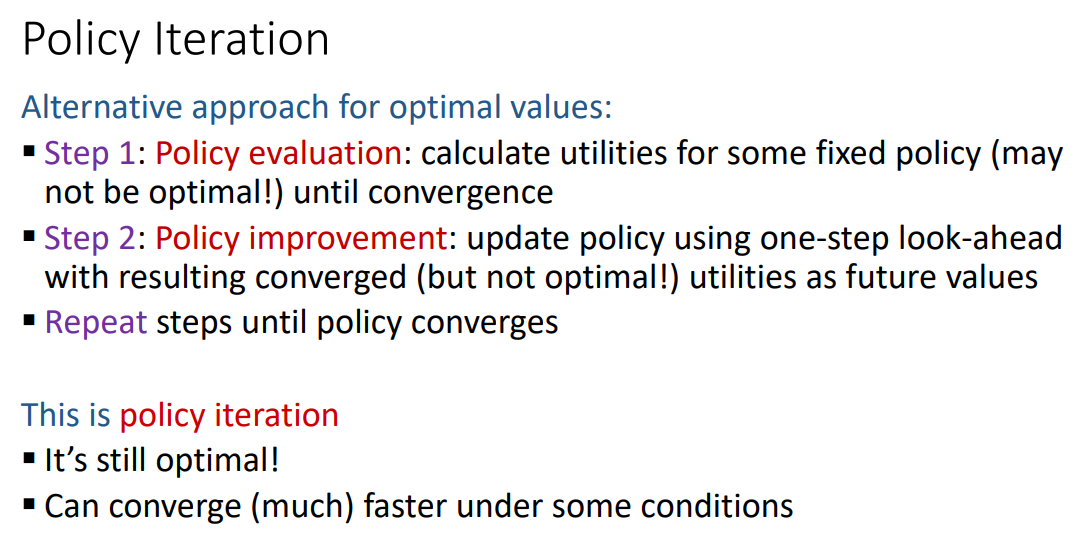
为了得到清晰的Value图,经常使用动态规划中的Bellman方法,存在Value Iteration和Policy Iteration两种实现。
Value Iteration每轮检查每个状态是否更新Value直至收敛,每轮时间复杂度$O(|S|^2|A|)$:
Policy Iteration从固定Policy出发,更新完一轮后寻找更好的Policy并重复直至收敛,每轮时间复杂度$O(|S|^2)$:
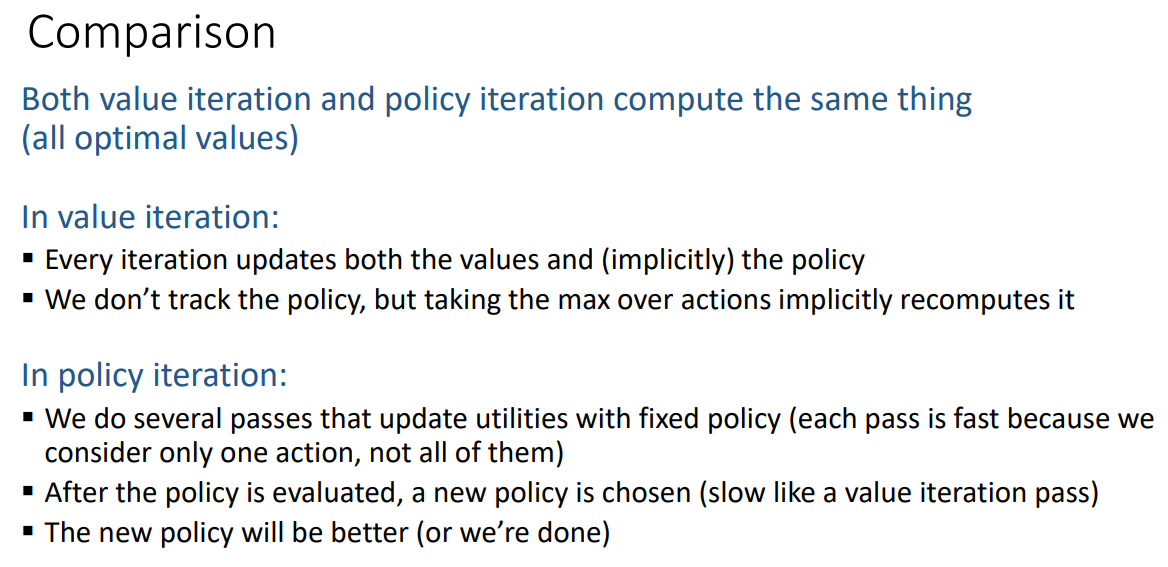
两种算法的比较:
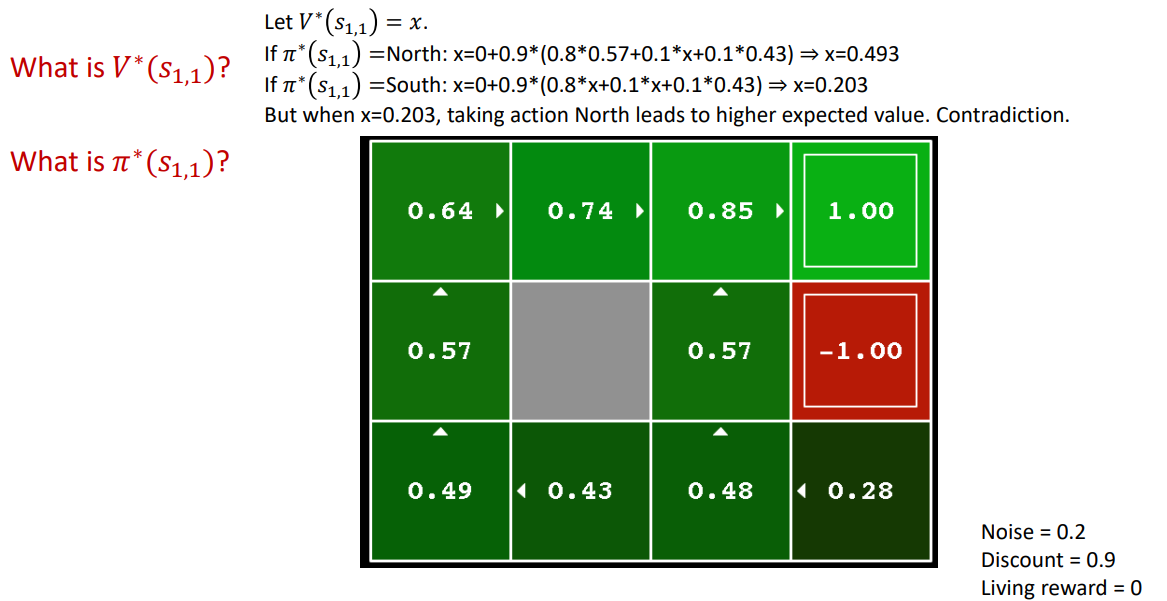
仅需要解一个状态的Value时:
最后,MDP涉及到的公式:
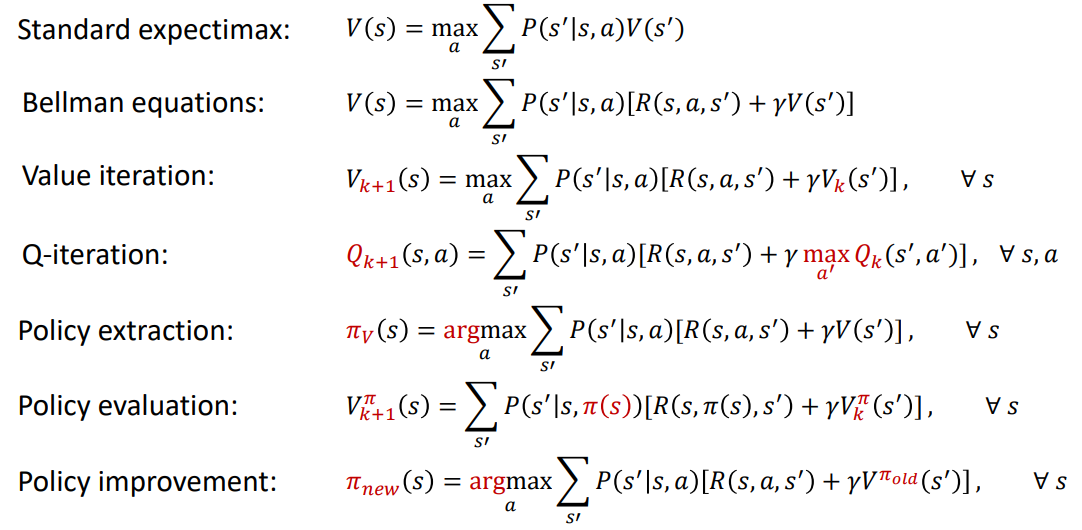
MDP是RL的前奏,这一部分中所有状态转移概率、奖励信息都是已知的,所以是一个可以全局考虑的离线问题。但是RL中这些信息可能都未知,就需要试错探索和更新策略,这才是Learning。
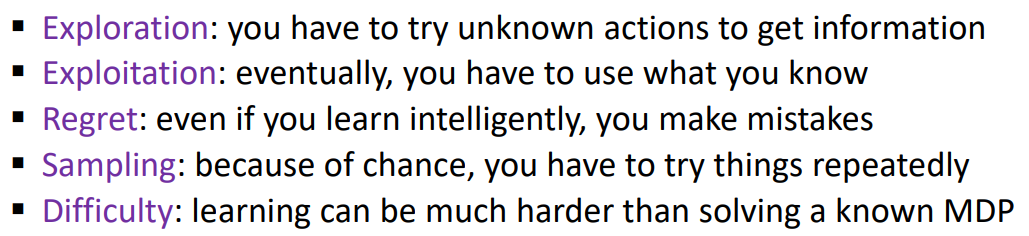
Towards Reinforcement Learning
- 条件:T和R未知,可以重复试验(episodes)
- 目标:找到最佳Policy。
- 常见概念:
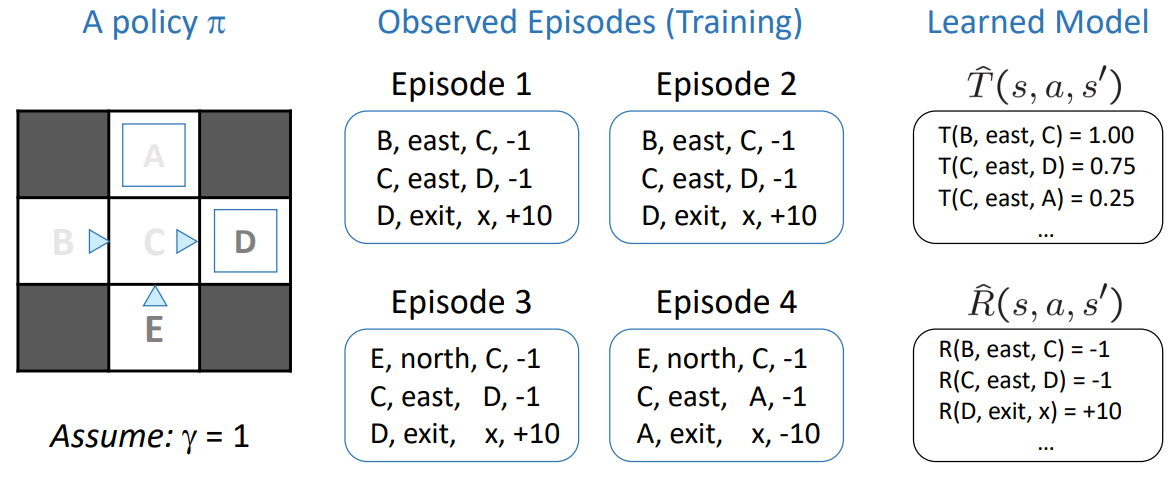
Model-Based Learning:较容易想到对T和R进行经验性建模,下面是例子。
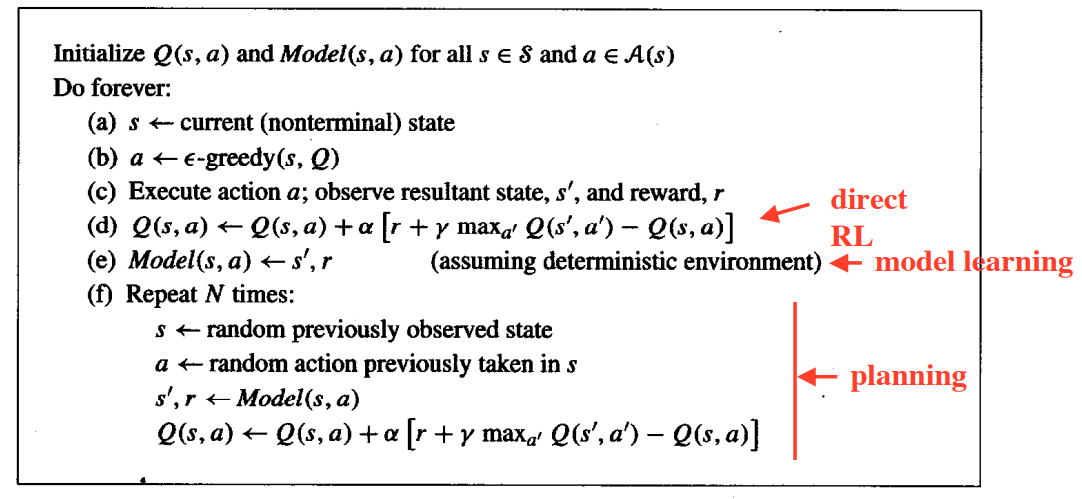
- Dyna-Q:维护一个依据真实经验进行模拟训练的Value图,每次真实交互后进行N次模拟更新,从而充分利用已有经验。这样会使得学习速度显著加快,策略收敛加快,适合于样本昂贵的场景。基本算法如下:
Model-Free Learning:不直接建模T和R,而是直接学习Value图。策略固定时也称为Passive Reinforcement Learning。
- Direct Evaluation:在固定策略下对某状态采样得到的值直接取平均。由于没有利用MDP特征,学习耗时较长。
Temporal Difference (Value) Learning:联合Policy Evaluation和指数平均移动,一次只更新单个状态。
Q-Learning:利用TD Learning学习Q-Value图。
这是一种off-policy learning,即通过不同的policy学到了最佳policy。反之on-policy learning则是仅学习到policy涉及的值。
- SARSA:State-Aciton-Reward-State-Aciton,是一种on-policy learning。与Q-Learning的区别仅在于更新Q值时直接依据当前策略,即
Exploration:既需要学习到未走过的区域,又要保持较优的策略。
- Random Actions:每一步以小概率$\epsilon$随机行动,其余概率以最佳策略行动。为了最后能仅执行最佳策略,可以随时间减小$\epsilon$。
Exploration Function:奖励未经探索或鲜少探索的状态,这种奖励会随探索次数增加而逐渐降低,如
Regret是当前策略获得的奖励和最佳策略奖励(事后之明)的误差,前两种探索方式中后一种的Regret更小,因为额外奖励。
Generalizing States:由于复杂问题或者真实世界中状态几乎无限多,我们可以用有限种情况来估计所有情况的Q-Value。
- States或Q-state可以使用特征向量来建模,每个维度描述了某个状态中的某个特征,如离终点的距离、敌人距离、局部环境特征等等。
Linear Value Function:用特征和权重对Value和Q-Value进行一阶线性表示
权重的更新则可以通过对Error求偏导计算,非线性表示的更新规则相同
NN的引入可以构造更复杂的表示函数,知名案例有Deep Q-Networks、AlphaGo等。
思考:实际上,以上所有对Value的更新过程可以看作一种对贝尔曼方程(如下)的解的逼近做法,看起来类似于自回归,但单个Value仅为一个方程解,而自回归是在拟合一个关于时间的函数,所以两者有本质区别。
Probabilistic Graphical Models
Bayesian Nets
贝叶斯网络用节点表示随机变量,用有向连接的父子关系表示条件概率,显然为DAG。联合概率即被表示为:
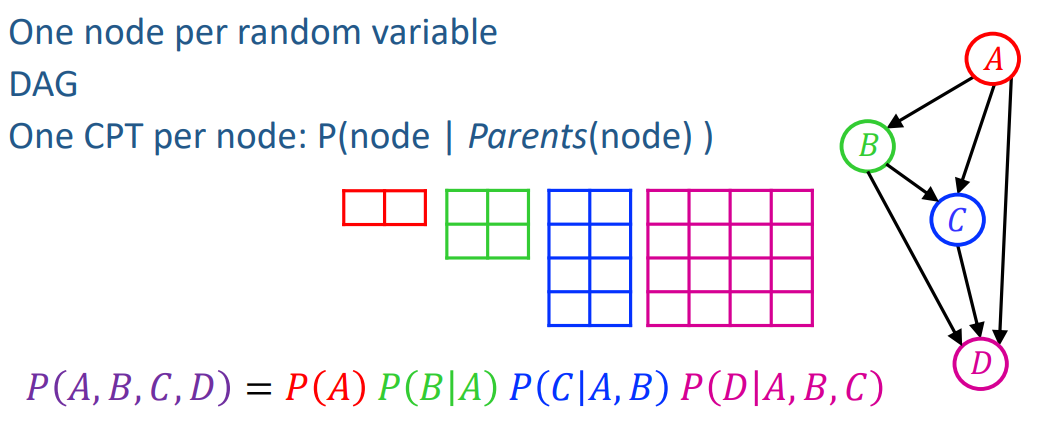
描述所有联合变量情况的表太过庞大,其中许多关系并非必要,这也使得贝叶斯网络过于庞大。我们利用条件独立(Conditional Independence)削减网络规模。
条件独立
如是否下雨、是否交通拥堵和是否打伞三个二元随机变量,虽然下雨大概率导致交通拥堵和打伞,但是有了是否下雨这个条件后交通拥堵与打伞间没有必然联系,因而是否交通拥堵和是否打伞关于是否下雨相互条件独立。这种关系比变量间的独立性更容易存在,因为它精细地描述了事物间的因果关系,排除了一些不重要的联系。条件独立用符号表示为:
$$\forall x,y,z; P(x|y,z)=P(x|z) ; or ; P(x,y|z)=P(x|z)P(y|z)$$
运用条件独立的贝叶斯网络中有两种常见结构:
- 共同原因:$X\leftarrow Y \rightarrow Z: P(x,y,z)=P(y)P(x|y)P(z|y)$,已知Y后X与Z相互条件独立,这表明观察到的共同原因会阻断效果间依赖,证明:
- 共同效果:$X\rightarrow Z \leftarrow Y: P(x,y,z)=P(x)P(y)P(z|x,y)$,X和Y相互独立,但已知Z后X、Y不一定相互独立,这表明观察到的共同效果会激发两个原因的依赖关系,独立性的证明:
贝叶斯球(Bayes Ball):一种在贝叶斯网络里判断已知条件下变量间是否相互条件独立的方法,步骤:
- 给已知随机变量着色
- 在某个待判断变量处放置一个球
- 球能以任意方向通过active path,而被inactive path阻挡
- 球可达另一待判断变量,则表明这两个变量在已知条件下不条件独立
Active Path与Inactive Path:主要是根据共同原因、共同效果和链状连接的性质进行判断
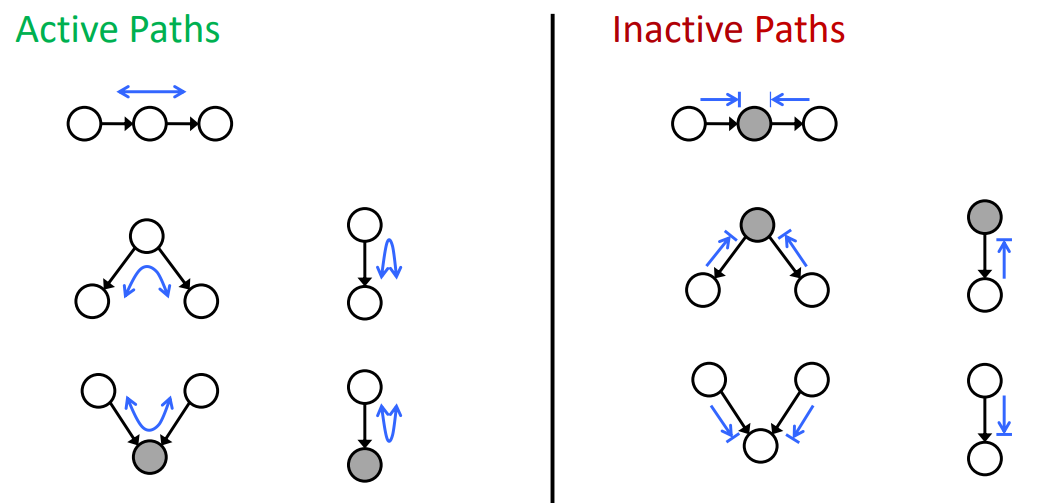
Markov Blanket:变量的马尔可夫毯包含它的父节点、子节点和子节点的其他父节点,已知它的马尔科夫毯会使其与其他所有变量条件独立。
Normalization:有时我们比较同一已知条件的条件概率大小,此时跳过其分母,如
Variable Elimination:一种简单的精确条件概率(Exact Inference from Conditional Probability Table)算法,其思想是列出所有隐藏变量并优先将它们通过求和消除,这过程中隐藏变量的顺序会影响最后逐点相乘的计算量,找到最优顺序是NP-hard问题。算法框架如下
1 | |
Sampling:与精确相对,Approximate Inference from CPT,有以下几种采样方法
- Prior Sampling:对贝叶斯网络中的所有变量进行采样,采样和概率算法如下
python 1
2
3
4
5w=1.0
For i=1, 2, …, n
Sample xi from P(Xi| Parents(Xi))
w = w * P(xi| Parents(Xi))
Return (x1, x2, …, xn), w - Rejection Sampling:为求条件概率,丢弃所有不合条件的采样,算法如下
python 1
2
3
4
5
6IN: evidence instantiation
For i=1, 2, …, n
Sample xi from P(Xi| Parents(Xi))
If xi not consistent with evidence
Reject: Return, and no sample is generated in this cycle
Return (x1, x2, …, xn) - Likelihood Weighting:为充分利用采样,通过先验条件变量的概率给予权重,采样非条件变量,从而达到固定条件变量的目的,算法如下
python 1
2
3
4
5
6
7
8
9IN: evidence instantiation
w = 1.0
for i=1, 2, …, n
if Xi is an evidence variable
xi = observation xi for Xi
Set w = w * P(xi| Parents(Xi))
else
Sample xi from P(Xi| Parents(Xi))
return (x1, x2, …, xn), w - Gibbs Sampling:为充分利用已知的先验变量和已抽取的后验变量,我们每次仅对一个非条件变量进行采样,并以固定的先验值和采样过的后验值为条件,v重复此采样过程。采样中可以每隔一定采样次数计入一个采样,以达到采样稳态分布的目的。这是一种Markov Chain Monte Carlo方法,对复杂的多维变量概率问题非常有效。算法框架如下:
python 1
2
3IN: Arbitrary instantiation consistent with the evidence
for k(technically infinite) sampling times
Resample xi from P(Xi| all other variables) for Xi not among the evidence variables
参考PPT:Bayes Nets, Bayes Nets Independence, Bayes Nets Inference, Bayes Nets Sampling
Hidden Markov Models
在贝叶斯网络的基础上,从时间或空间的角度上观察一个随机变量(或称状态)序列,或者说一个(一阶)马尔可夫链,我们有以下基本假设:
- 状态转移概率来自一个稳态分布
- 以现在状态为条件时,过去状态与未来状态相互独立
- 每个状态只依赖上一个状态
马尔可夫链的状态转移公式很简单:
隐马尔可夫模型(HMM)中,状态是不直接可见的,只能观察到由当前状态引发的先验,现实中语音识别、机器翻译等等都是这种模型。精确查询HMM的联合分布可以用以下公式:
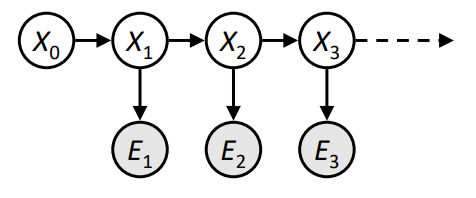
除联合分布外,精确查询HMM通常有以下几种情况:
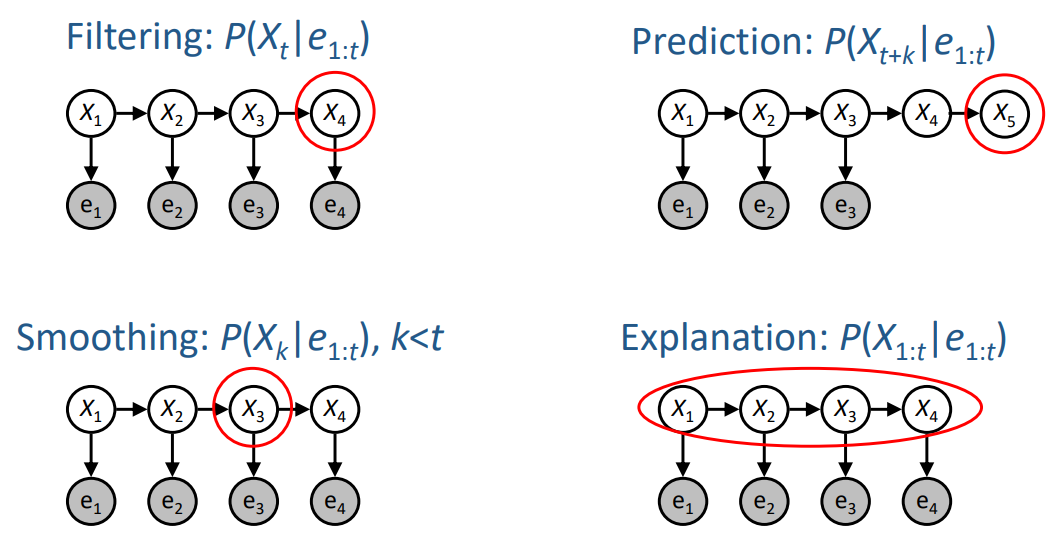
其中Filtering可以看作以现在和过去的先验为条件,当前的状态的条件概率,其公式推导过程如下:
时间和空间复杂度为$O(|X|^2), \;|X|$是状态数,通常非常大。
Particle Filtering:从状态极多甚至连续的空间中近似查询HMM的方法,其核心思想是。该方法为求$p(x_t|e_{1:t})$,首先随机进行N个采样(或称粒子),接下来在三个步骤间循环:
- 预测:直接根据状态转移模型生成新粒子,$x_t^{i}~p(x_t|x_{t-1}^i)$。
- 权重更新:根据观测调整所有粒子的可信度(初始为1),$\tilde{w}_t^i=w_{t-1}^i\cdot p(e_t|x_t^i)$,再归一化$w_t^i=\tilde{w}_t^i/(\sum_{j=1}^N \tilde{w}_t^j)$。
- 重采样:按照新权重重新采样N个粒子,从而将粒子聚集到权重大的状态,淘汰权重小的状态,解决粒子退化的问题。
在第二步中更新得到的权重和第三步中重采样的粒子实际在$|X|=N$的空间内近似计算了$p(x_t|e_{1:t})$:
猫才毛
Live for what I love ~